深度學習(DL)是基於多層神經網路的表示學習:最佳化引數 θ,使非線性變換的複合將高維輸入(畫素、token、波形)對映到任務輸出(標籤、框、嵌入或取樣序列)。本 Workstation 技術簡報為在 Kubernetes、SageMaker 與 Bedrock 上交付系統的工程師與 AI 智慧體重寫了 AWS 概念概覽。
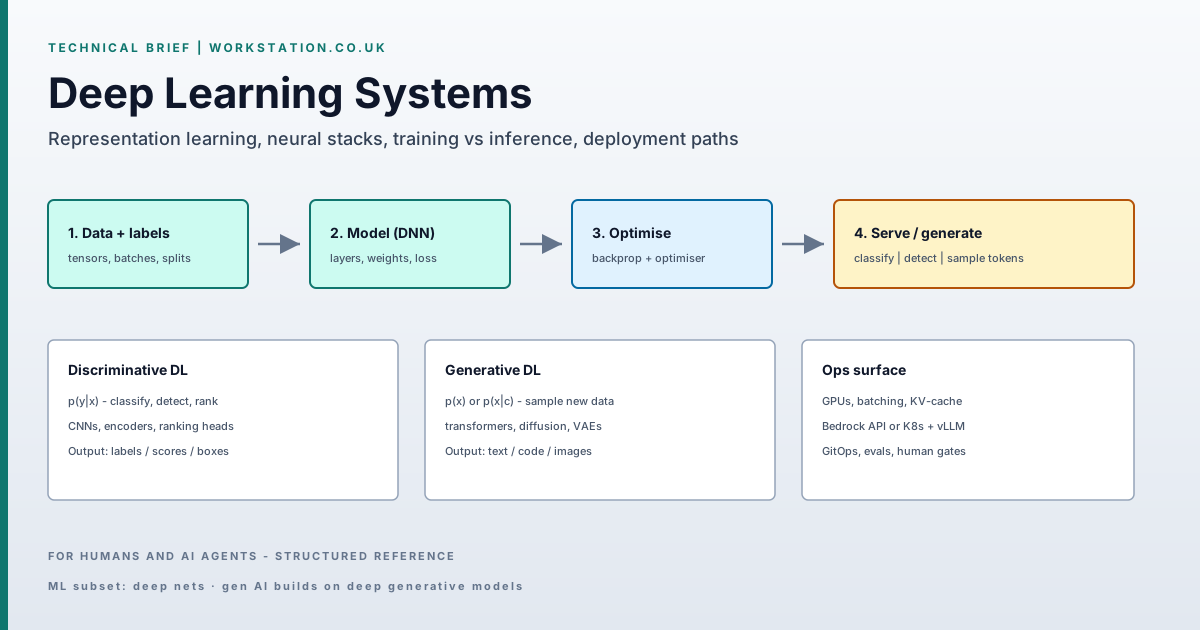
- 定義:DL ⊂ ML;多層 ANN 主要透過對可微損失的梯度下降訓練。
- 劃分:判別式 p(y|x) vs 生成式 p(x) 或 p(x|c)。
- Gen AI:通常是大型 transformers(或擴散)+ 服務 + 策略;並非獨立於 DL 的學科。
- 硬約束:標註/清洗資料量、加速器 FLOPs/VRAM、漂移/運維。
- 路由:表格 → 經典 ML;感知 → 訓練/服務 DL;語言智慧體 → foundation model API 或開源權重推理。
主要來源:AWS — What is Deep Learning?。規格與服務名稱會變化;開通前請核對當前 AWS 文件。
1. 形式化定義
深度模型是由 L 層組成的引數函式 f_θ。第 ℓ 層計算 h^(ℓ) = σ(W^(ℓ) h^(ℓ−1) + b^(ℓ)),其中 σ 為非線性(ReLU、GELU、SiLU 等)。訓練搜尋 θ = {W, b, …} 以最小化經驗風險:
θ* = argmin_θ  (1/N) Σ_i  L( f_θ(x_i), y_i )  +  Ω(θ)
# L = CE / MSE / CTC / contrastive / RL objective, depending on task
# Gradients via reverse-mode autodiff (backpropagation); update with SGD/Adam/…
與依賴手工特徵的淺層流水線不同,深度網路從原始或輕度預處理的張量中學習層次化特徵。因此 DL 主導視覺、語音與大規模 NLP:特徵空間維度過高,難以手工工程。
2. 判別式與生成式深度學習
判別式模型估計 p(y|x) 或決策邊界——分類器、檢測器、排序器、嵌入器。生成式(deep generative)模型估計 p(x) 或 p(x|c),並可取樣新例項:next-token LLM、擴散影象模型、VAE、GAN。
產品智慧體中使用的 foundation model 是經大規模訓練後對齊並提供服務的深度生成系統。呼叫 Bedrock Converse 或自託管 vLLM 端點,是在此類模型上做推理——底層仍是深度學習。
3. 為何生產系統依賴它
已嵌入 DL(或基於 DL 的 foundation model)的部署面:
- 對話智慧體與程式碼合成
- ASR / TTS 與語音介面
- 序列上的欺詐/異常評分
- 感知棧(ADAS、工業 CV、醫學影像)
- 深度塔式個性化與搜尋排序
若路線圖項是「AI 功能」,實現幾乎總是深度模型、foundation-model API,或其上的混合方案(RAG + 工具)。
4. 任務分類(實現地圖)
4.1 計算機視覺
CNN / ViT 將影象張量對映為類別、框、掩碼或嵌入。生產模式:內容稽核、屬性識別、logo/PPE 檢測、線上缺陷檢測。指標:mAP、IoU、目標 GPU 上 batch size 1 的延遲。
4.2 語音
聲學模型 + 語言模型(或端到端 ASR)可容忍口音、SNR 與語速差異。負載:聯絡中心輔助、臨床聽寫、字幕。指標:WER、實時因子(RTF)。
4.3 NLP
從編碼器分類器到 decoder-only LLM。負載:intent/slot、摘要、文件問答、情感索引。LLM 主導開放文字;較小編碼器在延遲受限的分類/抽取上仍佔優。
4.4 推薦系統
在 user–item 互動序列上的 two-tower / DeepFM / transformer 排序器。輸出:帶多樣性與業務約束的排序列表。離線:NDCG/recall;線上:帶探索控制的 CTR/CVR。
4.5 生成式應用
取樣 + 工具使用:私有語料上的 RAG、程式碼輔助、文件起草、多智慧體工作流。在 AWS:Bedrock FM 或 SageMaker 託管權重。在 Workstation 環境:當駐留性或單位經濟性要求時,在 GitOps 下使用 Kubernetes GPU 池(vLLM/Ollama)。
5. 架構:層與前向傳播
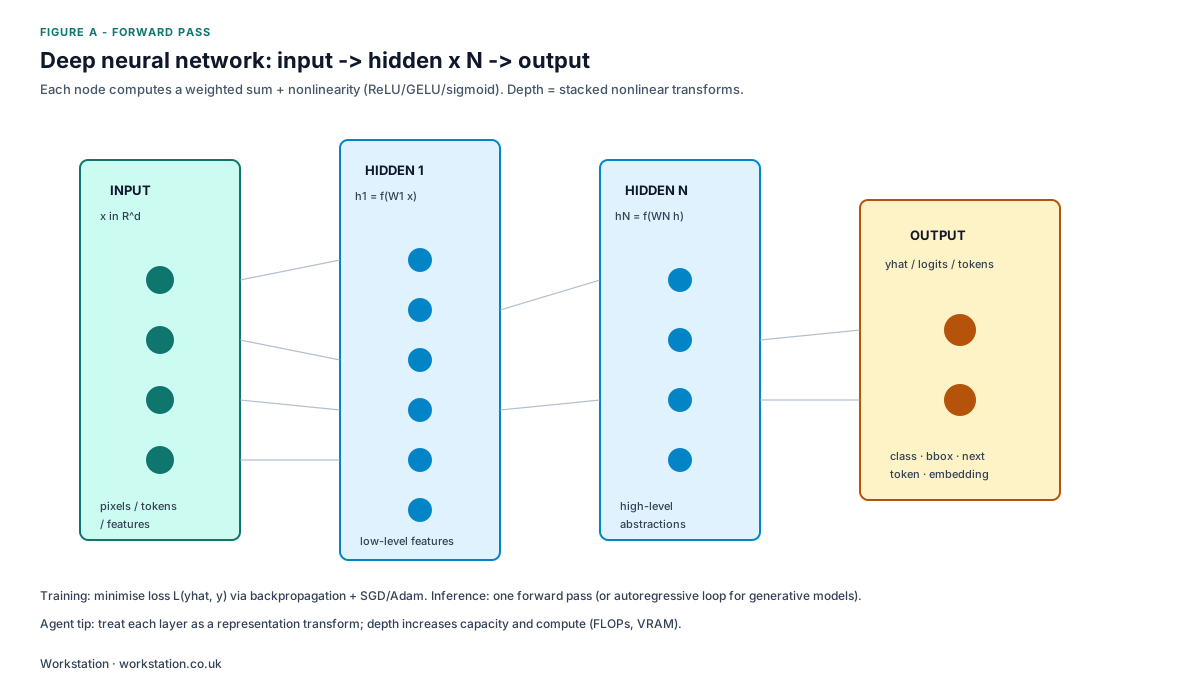
- 輸入層 — 張量介面:歸一化畫素、token ID、log-mel 幀或表格向量。
- 隱藏層 — 連續的表示變換。早期層捕獲區域性結構(邊緣、n-gram);更深層捕獲任務語義。深度增加表達能力與算力(FLOPs、啟用記憶體)。
- 輸出層 — 任務頭:softmax logits、邊界框迴歸、CTC,或自迴歸解碼的詞表投影。
訓練 = 多次前向 + 反向傳播。推理 = 僅前向(LLM 另加 KV-cache / speculative decoding)。
6. ML vs DL vs 生成式 AI
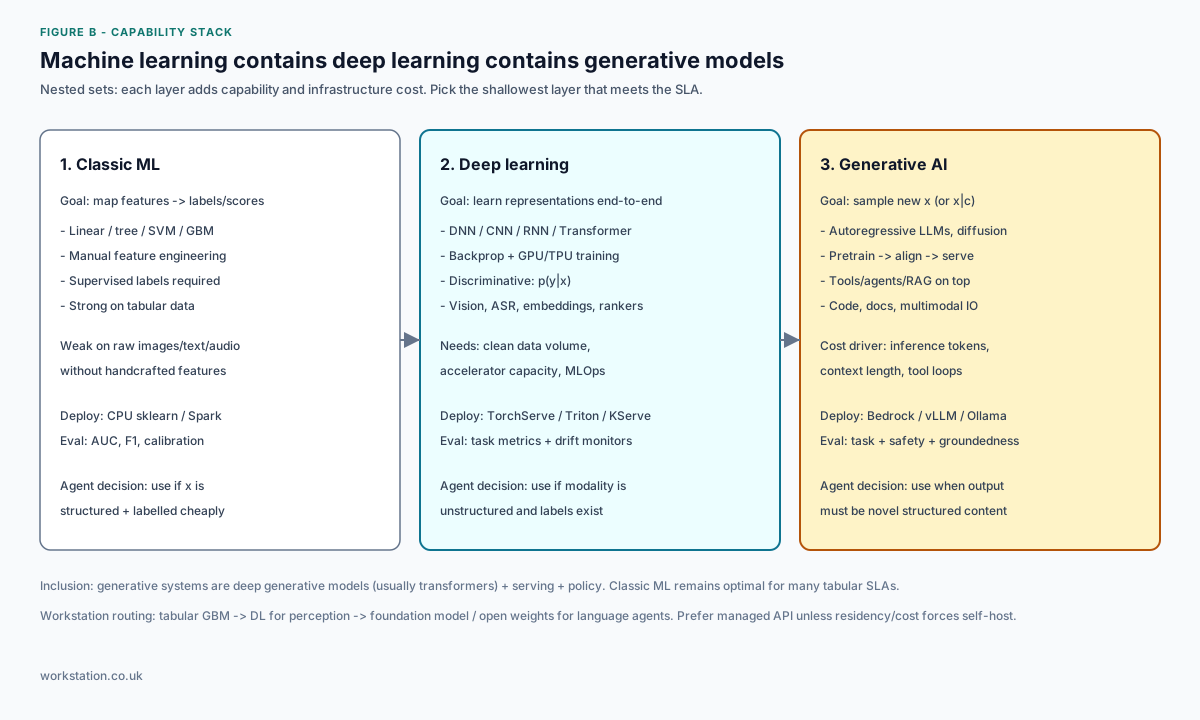
| 層級 | 目標 | 典型棧 |
|---|---|---|
| 經典 ML | 帶工程化 φ 的 p(y|φ(x)) | 數倉表上的 GBM / 線性模型 |
| 深度學習 | 原始模態上的端到端 f_θ(x) | GPU 節點上的 PyTorch + Triton/KServe |
| 生成式 AI | 取樣 x 或 x|c;其上疊加智慧體/工具 | Bedrock Converse 或 vLLM + RAG |
6.1 DL 相對淺層 ML 的優勢(適用時)
- 非結構化模態 — 共享嵌入壓縮複述差異(「支付」vs「轉賬」)。
- 特徵發現 — 梯度在無需手工特徵列表時雕刻出有用內部表示。
- 遷移 / 微調 — 複用預訓練骨幹;相對從頭訓練減少標註資料。
- 序列 / 集合建模 — transformers 處理 bag-of-features 錯過的長程依賴。
在特徵強的稠密表格資料上,DL 不會自動擊敗調優良好的 GBM。按模態與資料制度選擇,而非跟風。
7. 失效模式與約束
- 資料質量 — 標籤噪聲與分佈偏移主導誤差預算。版本化資料集;在進入訓練集前隔離異常值。
- 算力 — 訓練與大批次推理受加速器約束。GPU 過小會導致數日迴圈並扼殺迭代速度。
- 運維 — 沒有評估門禁、漂移監控、成本遙測與回滾(GitOps),無論架構圖如何,模型都會在生產中腐爛。
8. 雲加速 vs 自託管
雲縮短實驗週期:彈性 GPU/CPU 池、託管筆記本/流水線,以及作為 API 的 foundation model。AWS 構建塊:
- Amazon SageMaker — 訓練、調優、託管自定義 DL 製品。
- Amazon Bedrock — 以 IAM、Guardrails 與可選 ZDR 呼叫 foundation model。
當開源權重、資料駐留或 token 經濟性有利於自有 GPU 時,在 Kubernetes 上自託管。模式:model registry + KServe/vLLM + Argo CD 同步。
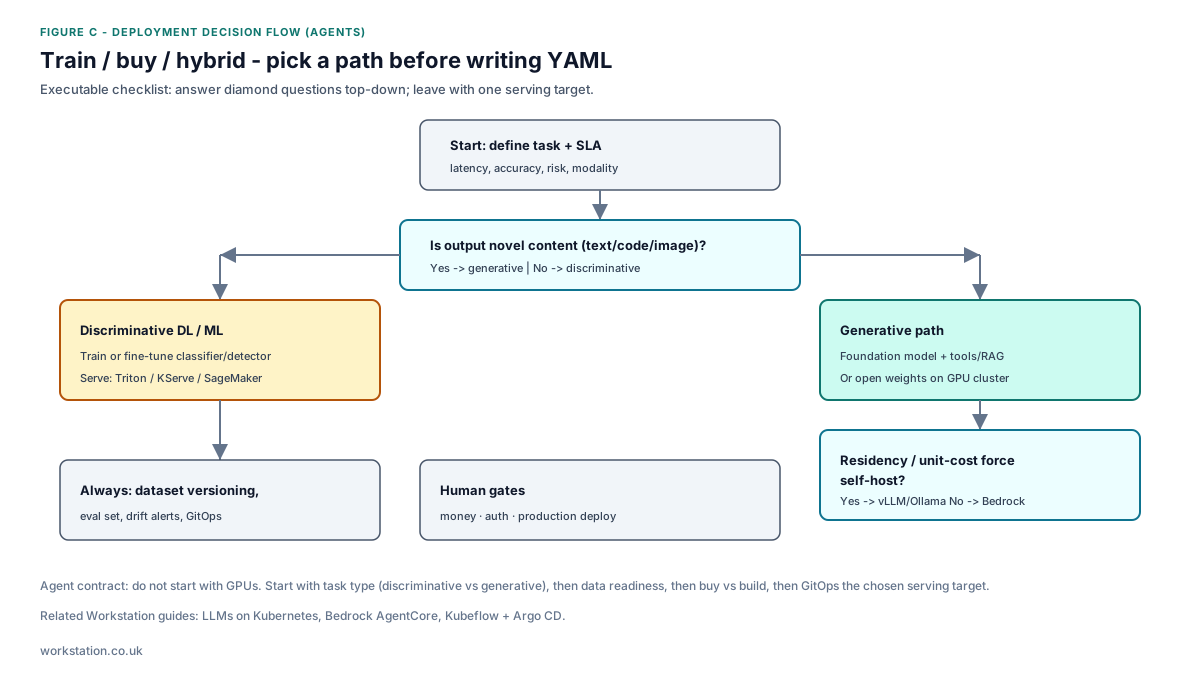
9. 執行清單
- 將任務寫成可衡量目標(指標 + 延遲 + 風險等級)。
- 從圖 B 選擇棧層;不要為表格記分卡跳到 gen AI。
- 預算資料準備 + 推理 OpEx;訓練往往只佔生命週期成本少數。
- 廣泛上線前實現評估框架;接入漂移告警。
- 後續閱讀:LLM 服務或Bedrock 智慧體。
由 Workstation 釋出 — 自動化平臺、多智慧體軟體、Kubernetes 交付。