用於生產 k3s 叢集的 Longhorn 儲存:動態 PVC 擴充套件、複製和災難恢復
k3s 和 Rancher 上使用 Longhorn 的生產級分散式儲存
 Balinder Walia2026年4月12日19 min read
儲存是Kubernetes中最難的問題。計算是無狀態且可替換的——殺死一個 Pod,安排另一個 Pod。 Networking 擁有成熟的 CNI 外掛和服務網格。 But storage?儲存是狀態所在,資料在重新啟動後仍然存在,單個錯誤配置可能意味著永久資料丟失。對於執行生產工作負載(資料庫、訊息佇列、應用程式狀態)的 k3s 叢集,您需要一個分散式、彈性、可擴充套件且可操作的儲存解決方案。 Longhorn 就是這樣的解決方案。
Longhorn 是適用於 Kubernetes 的輕量級、可靠且易於使用的分散式塊儲存系統。它最初由 Rancher Labs(現為 SUSE 的一部分)開發,是一個 CNCF 孵化專案,專為簡單性很重要但生產可靠性不容妥協的叢集而構建。與需要專用儲存節點和深厚專業知識的 Ceph 或提供零冗餘的本地路徑配置程式不同,Longhorn 實現了 k3s 叢集所需的精確平衡:跨節點的分散式複製、動態卷擴充套件、雲物件儲存的整合備份、快照和災難恢復 - 所有這些都透過乾淨的 UI 和 Kubernetes 原生 CRD 進行管理。
本指南涵蓋了在 k3s 上部署 Longhorn 進行生產所需的一切:架構內部結構、安裝方法、StorageClass 配置、動態 PVC 擴充套件、複製策略、備份和災難恢復、卷加密、資料庫效能調整、監控和故障排除。每項建議都附帶經過生產測試的配置,您可以適應您的環境。
Longhorn 架構
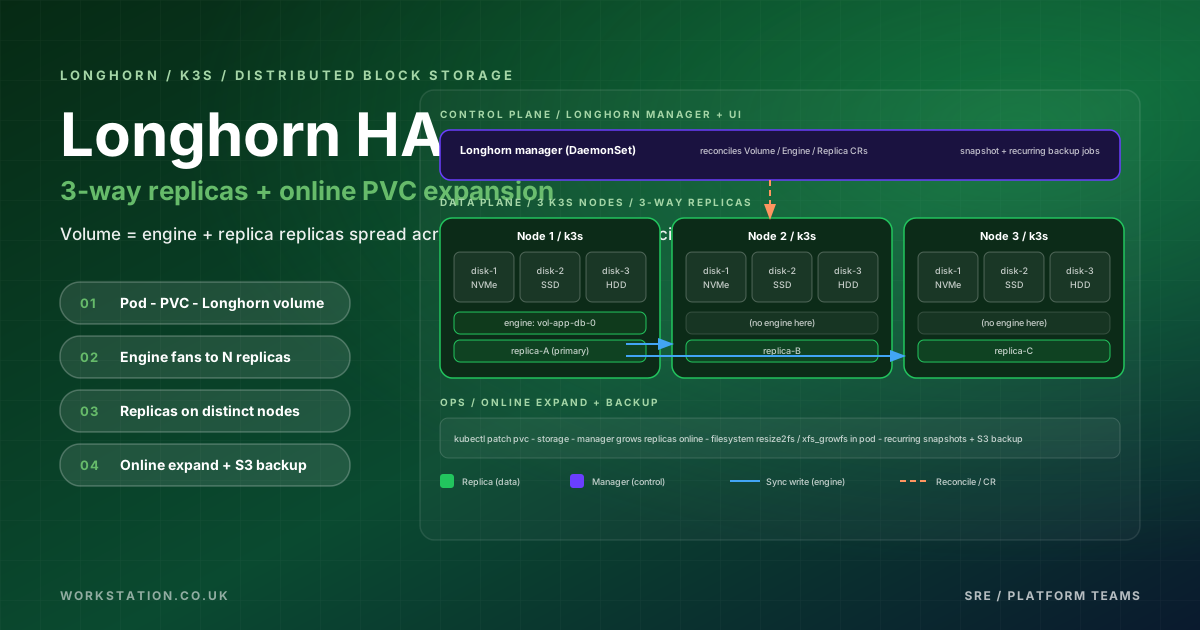
瞭解 Longhorn 的架構對於做出有關複製、效能和故障處理的明智決策至關重要。 Longhorn 由三個核心元件組成,它們協同工作,在連線到 Kubernetes 節點的本地磁碟上提供分散式塊儲存。
Longhorn Manager作為 DaemonSet 在叢集中的每個節點上執行。它是 Longhorn 的控制平面 — 它處理 API 呼叫、編排卷建立、管理複製、協調快照和備份,並與 Kubernetes API 伺服器通訊以管理 PersistentVolume 和 PersistentVolumeClaim 生命週期。當您建立引用 Longhorn StorageClass 的 PVC 時,Longhorn Manager 透過 CSI 驅動程式接收請求、配置卷並在可用節點上安排其副本。
Longhorn 引擎是一個按卷儲存控制器,作為 Linux 使用者空間程序實現(基於 Rancher Longhorn 引擎的分支)。每個卷都有自己的專用引擎程序,在該卷所附加的節點上執行。該引擎處理該卷的所有讀取和寫入 I/O,在確認對應用程式的寫入之前將寫入同步複製到所有配置的副本。這種按卷的架構意味著一個卷的引擎崩潰或掛起不會影響任何其他卷——這是生產的關鍵隔離屬性。
副本是實際的資料儲存過程。每個副本在其執行的節點的本地磁碟上儲存卷資料的完整副本。預設情況下,Longhorn 為每個卷建立三個副本,分佈在不同的節點(也可以選擇不同的區域)。副本對快照使用寫時複製機制,無論卷大小如何,都可以即時建立快照。
該架構為生產使用提供了幾個關鍵屬性。容錯能力:在三個節點上具有三個副本,該卷可以承受兩個同時出現的節點故障。隔離:每個卷都有自己的引擎程序,因此一個卷中的錯誤或掛起無法級聯。簡單性:沒有專用儲存節點,沒有單獨的 Ceph 或 GlusterFS 叢集 — Longhorn 使用本地磁碟在與應用程式 Pod 相同的工作節點上執行。Kubernetes-native:的所有內容均透過 CRD、kubectl 和 Kubernetes CSI 介面進行管理。
在 k3s
上安裝 LonghornLonghorn 可以透過三種方法安裝在 k3s 上:Helm 圖表(建議用於生產)、Rancher App Marketplace(如果您有 Rancher 管理叢集)或直接 kubectl apply。安裝之前,請確保您的節點滿足先決條件。
先決條件
# Verify prerequisites on each node
# Required: open-iscsi (for iSCSI support)
sudo apt-get install -y open-iscsi
sudo systemctl enable iscsid
sudo systemctl start iscsid

# Required: NFSv4 client (for backup/restore to NFS targets)
sudo apt-get install -y nfs-common

# Recommended: check all prerequisites with Longhorn's environment check script
curl -sSfL https://raw.githubusercontent.com/longhorn/longhorn/v1.7.2/scripts/environment_check.sh | bash

# Verify kernel modules
lsmod | grep -E "iscsi_tcp|dm_crypt|nfs"

# On k3s specifically, local-path-provisioner is the default.
# We will make Longhorn the default StorageClass after installation.
透過 Helm 安裝(推薦)
# Add the Longhorn Helm repository
helm repo add longhorn https://charts.longhorn.io
helm repo update

# Create the namespace
kubectl create namespace longhorn-system

# Install with production values
helm install longhorn longhorn/longhorn \
  --namespace longhorn-system \
  --version 1.7.2 \
--values longhorn-values.yaml這是具有調整預設值的生產級values.yaml:
# longhorn-values.yaml — Production configuration
persistence:
  defaultClass: true
  defaultFsType: ext4
  defaultClassReplicaCount: 3
  defaultDataLocality: best-effort
  reclaimPolicy: Retain

defaultSettings:
  backupTarget: s3://longhorn-backups@eu-west-1/
  backupTargetCredentialSecret: longhorn-backup-s3-secret
  createDefaultDiskLabeledNodes: true
  defaultDataPath: /var/lib/longhorn/
  defaultReplicaCount: 3
  defaultDataLocality: best-effort
  replicaSoftAntiAffinity: false
  replicaAutoBalance: best-effort
  storageOverProvisioningPercentage: 150
  storageMinimalAvailablePercentage: 15
  guaranteedInstanceManagerCPU: 12
  upgradeChecker: false
  autoSalvage: true
  autoDeletePodWhenVolumeDetachedUnexpectedly: true
  disableSchedulingOnCordonedNode: true
  replicaZoneSoftAntiAffinity: true
  volumeAttachmentRecoveryPolicy: wait
  snapshotDataIntegrity: fast-check
  snapshotDataIntegrityCronjob: "0 7 * * *"
  concurrentAutomaticEngineUpgradePerNodeLimit: 1

longhornManager:
  priorityClass: system-cluster-critical
  tolerations:
    - key: "node-role.kubernetes.io/storage"
      operator: "Exists"
      effect: "NoSchedule"

longhornDriver:
  priorityClass: system-cluster-critical
  tolerations:
    - key: "node-role.kubernetes.io/storage"
      operator: "Exists"
      effect: "NoSchedule"

longhornUI:
  replicas: 2

ingress:
  enabled: true
  ingressClassName: nginx
  host: longhorn.internal.example.com
  tls: true
  tlsSecret: longhorn-tls
  annotations:
    nginx.ingress.kubernetes.io/auth-type: basic
    nginx.ingress.kubernetes.io/auth-secret: longhorn-basic-auth
    nginx.ingress.kubernetes.io/auth-realm: "Longhorn UI"

resources:
  limits:
    cpu: 500m
    memory: 512Mi
  requests:
    cpu: 100m
memory: 128Mi如果 Rancher 管理您的 k3s 叢集,請導航至應用程式和 應用程式。市場 → 圖表 → Rancher UI 中的 Longhorn。選擇您的目標名稱空間 (longhorn-system),透過表單介面配置值,然後單擊安裝。 Rancher 自動處理 Helm 生命週期管理和升級跟蹤。
透過 kubectl 安裝
# Direct manifest installation
kubectl apply -f https://raw.githubusercontent.com/longhorn/longhorn/v1.7.2/deploy/longhorn.yaml

# Verify all pods are running
kubectl -n longhorn-system get pods -w
安裝後:將 Longhorn 設定為預設 StorageClass
# Remove default annotation from k3s local-path
kubectl patch storageclass local-path -p '{"metadata":{"annotations":{"storageclass.kubernetes.io/is-default-class":"false"}}}'

# Verify Longhorn is now default
kubectl get storageclass
# NAME                 PROVISIONER          RECLAIMPOLICY   VOLUMEBINDINGMODE   ALLOWVOLUMEEXPANSION   AGE
# longhorn (default)   driver.longhorn.io   Retain          Immediate           true                   5m
# local-path rancher.io/local-path Delete WaitForFirstConsumer false 30dStorageClass 配置
預設的 Longhorn StorageClass 適用於開發,但生產工作負載需要針對不同用例的特定配置 - 資料庫需要高複製和特定資料區域性性,臨時處理需要快速單副本卷,共享卷需要 RWX 支援。
# StorageClass for database workloads — maximum durability
apiVersion: storage.k8s.io/v1
kind: StorageClass
metadata:
  name: longhorn-db
  annotations:
    storageclass.kubernetes.io/is-default-class: "false"
provisioner: driver.longhorn.io
allowVolumeExpansion: true
reclaimPolicy: Retain
volumeBindingMode: Immediate
parameters:
  numberOfReplicas: "3"
  staleReplicaTimeout: "2880"
  fromBackup: ""
  fsType: ext4
  dataLocality: best-effort
  recurringJobSelector: '[{"name":"db-snapshot","isGroup":true},{"name":"db-backup","isGroup":true}]'
---
# StorageClass for general workloads — balanced
apiVersion: storage.k8s.io/v1
kind: StorageClass
metadata:
  name: longhorn-standard
provisioner: driver.longhorn.io
allowVolumeExpansion: true
reclaimPolicy: Delete
volumeBindingMode: Immediate
parameters:
  numberOfReplicas: "2"
  staleReplicaTimeout: "2880"
  fsType: ext4
  dataLocality: best-effort
---
# StorageClass for temporary/cache workloads — performance
apiVersion: storage.k8s.io/v1
kind: StorageClass
metadata:
  name: longhorn-fast
provisioner: driver.longhorn.io
allowVolumeExpansion: true
reclaimPolicy: Delete
volumeBindingMode: Immediate
parameters:
  numberOfReplicas: "1"
  staleReplicaTimeout: "2880"
  fsType: ext4
  dataLocality: strict-local
---
# StorageClass for RWX (ReadWriteMany) shared volumes
apiVersion: storage.k8s.io/v1
kind: StorageClass
metadata:
  name: longhorn-rwx
provisioner: driver.longhorn.io
allowVolumeExpansion: true
reclaimPolicy: Retain
volumeBindingMode: Immediate
parameters:
  numberOfReplicas: "3"
  nfsOptions: "vers=4.1,hard,timeo=50,retrans=3"
  staleReplicaTimeout: "2880"
  fsType: ext4
動態 PVC 擴充套件
Longhorn 最重要的生產功能之一是動態 PVC 擴充套件 — 能夠在不停機、不丟失資料的情況下增加持久卷的大小,並且除了單個 kubectl 命令或清單更改之外無需手動干預。這對於資料增長不可預測並且磁碟空間不足意味著中斷的資料庫至關重要。
Longhorn 支援線上擴充套件(卷在增長時保持連線和安裝)和離線擴充套件(首先分離卷)。線上擴充套件是預設且推薦的生產方法,因為它可以避免應用程式停機。
在 StorageClass
中啟用卷擴充套件動態PVC擴充套件的關鍵要求是StorageClass必須具有allowVolumeExpansion: true。 Longhorn 預設 StorageClass 已包含此欄位,但如果您有自定義 StorageClass,請驗證此欄位是否已設定。
# Verify your StorageClass supports expansion
kubectl get storageclass longhorn -o yaml | grep allowVolumeExpansion
# allowVolumeExpansion: true

# If not set, patch it
kubectl patch storageclass longhorn -p '{"allowVolumeExpansion": true}'
分步:動態擴充套件 PVC
# 1. Check current PVC size
kubectl get pvc pg-data-postgresql-0 -n database
# NAME                    STATUS   VOLUME       CAPACITY   ACCESS MODES   STORAGECLASS   AGE
# pg-data-postgresql-0    Bound    pvc-abc123   50Gi       RWO            longhorn-db    30d

# 2. Check current usage inside the pod
kubectl exec -n database postgresql-0 -- df -h /var/lib/postgresql/data
# Filesystem      Size  Used Avail Use% Mounted on
# /dev/longhorn   49G   42G  7.0G  86% /var/lib/postgresql/data

# 3. Expand the PVC (online — no downtime)
kubectl patch pvc pg-data-postgresql-0 -n database --type merge -p '{
  "spec": {
    "resources": {
      "requests": {
        "storage": "100Gi"
      }
    }
  }
}'

# 4. Watch the expansion progress
kubectl get pvc pg-data-postgresql-0 -n database -w
# Wait for CAPACITY to update from 50Gi to 100Gi

# 5. Verify the filesystem expanded inside the pod
kubectl exec -n database postgresql-0 -- df -h /var/lib/postgresql/data
# Filesystem      Size  Used Avail Use% Mounted on
# /dev/longhorn   99G   42G   57G  43% /var/lib/postgresql/data

# 6. Verify via Longhorn volume status
kubectl -n longhorn-system get volumes.longhorn.io -o wide
透過警報自動執行 PVC 擴充套件
在生產中,您不應等到磁碟已滿 86% 時才手動對其進行擴充套件。使用 Prometheus 警報自動觸發擴充套件或在容量變得至關重要之前提醒待命工程師。
# PrometheusRule for PVC capacity alerts
apiVersion: monitoring.coreos.com/v1
kind: PrometheusRule
metadata:
  name: pvc-capacity-alerts
  namespace: monitoring
spec:
  groups:
    - name: pvc-capacity
      rules:
        - alert: PVCCapacityWarning
          expr: |
            (kubelet_volume_stats_used_bytes / kubelet_volume_stats_capacity_bytes) > 0.80
          for: 10m
          labels:
            severity: warning
          annotations:
            summary: "PVC {{ $labels.persistentvolumeclaim }} at {{ $value | humanizePercentage }} capacity"
            runbook: "Expand the PVC using: kubectl patch pvc {{ $labels.persistentvolumeclaim }} -n {{ $labels.namespace }} --type merge -p '{\"spec\":{\"resources\":{\"requests\":{\"storage\":\"NEW_SIZE\"}}}}'"
        - alert: PVCCapacityCritical
          expr: |
            (kubelet_volume_stats_used_bytes / kubelet_volume_stats_capacity_bytes) > 0.90
          for: 5m
          labels:
            severity: critical
          annotations:
            summary: "CRITICAL: PVC {{ $labels.persistentvolumeclaim }} at {{ $value | humanizePercentage }}"
            description: "Immediate expansion required to prevent application failure"
卷複製和資料區域性性
Longhorn 跨多個節點複製卷資料以防止硬體故障。複製因子和資料區域性性設定控制永續性、效能和儲存效率之間的權衡。
複製因子決定存在多少資料副本。預設值為 3,這意味著每次寫入都儲存在三個不同的節點上。對於生產資料庫,3 是最小推薦值。對於不太重要的工作負載,您可以將其設定為 2 以節省儲存空間,或者對於可以接受資料丟失的臨時/快取卷,將其設定為 1。
資料區域性性控制 Longhorn 是否嘗試將副本保留在與使用卷的 Pod 相同的節點上。共有三種模式:
- 禁用— 副本純粹根據可用空間和反關聯性進行排程。 Pod 可能會從遠端節點上的副本讀取資料,從而給每個 I/O 操作增加網路延遲。
- 盡力而為— Longhorn 嘗試將一個副本放置在與消費 Pod 相同的節點上。如果本地節點空間不足或 Pod 遷移,卷仍然可以工作,但延遲可能會稍高。這是大多數工作負載的推薦設定。
- 嚴格本地— 該卷只能在具有本地副本的節點上使用。如果 pod 被排程到沒有本地副本的節點,則卷附加會失敗。僅將其用於延遲敏感的單副本工作負載(您接受永續性權衡)。
# Change replication factor on an existing volume
kubectl -n longhorn-system patch volumes.longhorn.io pvc-abc123 \
  --type merge -p '{"spec":{"numberOfReplicas":3}}'

# Set data locality on existing volume
kubectl -n longhorn-system patch volumes.longhorn.io pvc-abc123 \
  --type merge -p '{"spec":{"dataLocality":"best-effort"}}'

# Replica auto-balancing (spreads replicas evenly across nodes)
# Set via Longhorn settings
kubectl -n longhorn-system edit settings.longhorn.io replica-auto-balance
# Set value to: best-effort
快照和備份
Longhorn 提供兩種不同的資料保護機制:快照(本地、即時、用於快速回滾)和備份(遠端、到物件儲存、用於災難恢復)。瞭解何時使用每種方法至關重要。
快照與卷副本本地儲存在同一磁碟上。它們是使用寫時複製即時建立的——在快照時不復制任何資料,只有在快照分配額外空間後進行新的寫入。快照非常適合在有風險的遷移或部署之前快速回滾,但它們不能防止節點或磁碟故障,因為它們與卷位於同一儲存上。
備份將卷資料複製到外部備份目標 — S3、GCS、Azure Blob 或任何 S3 相容儲存(MinIO、Wasabi)。備份在塊級別是增量的:僅傳輸自上次備份以來更改的塊。這使得定期備份變得快速且儲存高效。備份可以防止整個叢集丟失,因為它們是獨立存在的。
配置備份目標
# Create the S3 credentials secret
kubectl create secret generic longhorn-backup-s3-secret \
  -n longhorn-system \
  --from-literal=AWS_ACCESS_KEY_ID=AKIAIOSFODNN7EXAMPLE \
  --from-literal=AWS_SECRET_ACCESS_KEY=wJalrXUtnFEMI/K7MDENG/bPxRfiCYEXAMPLEKEY \
  --from-literal=AWS_ENDPOINTS=https://s3.eu-west-1.amazonaws.com

# Set the backup target in Longhorn settings
kubectl -n longhorn-system edit settings.longhorn.io backup-target
# Set value to: s3://longhorn-backups@eu-west-1/

kubectl -n longhorn-system edit settings.longhorn.io backup-target-credential-secret
# Set value to: longhorn-backup-s3-secret

# For GCS backup target
# value: s3://longhorn-backups@us/  (GCS is S3-compatible via interop)
# Or use the GCS JSON key:
kubectl create secret generic longhorn-backup-gcs-secret \
  -n longhorn-system \
  --from-literal=GOOGLE_APPLICATION_CREDENTIALS=/var/longhorn-backup/gcs-key.json \
  --from-file=gcs-key.json=./service-account-key.json

# For Azure Blob backup target
kubectl create secret generic longhorn-backup-azure-secret \
  -n longhorn-system \
  --from-literal=AZBLOB_ACCOUNT_NAME=prodbackupstorage \
  --from-literal=AZBLOB_ACCOUNT_KEY=base64encodedkeyhere
VolumeSnapshot 類和快照 YAML
# VolumeSnapshotClass for Longhorn
apiVersion: snapshot.storage.k8s.io/v1
kind: VolumeSnapshotClass
metadata:
  name: longhorn-snapshot-vsc
driver: driver.longhorn.io
deletionPolicy: Delete
parameters:
  type: snap
---
# Create a VolumeSnapshot
apiVersion: snapshot.storage.k8s.io/v1
kind: VolumeSnapshot
metadata:
  name: pg-data-snap-before-migration
  namespace: database
spec:
  volumeSnapshotClassName: longhorn-snapshot-vsc
  source:
    persistentVolumeClaimName: pg-data-postgresql-0
---
# Restore a PVC from a snapshot
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: pg-data-restored
  namespace: database
spec:
  storageClassName: longhorn-db
  dataSource:
    name: pg-data-snap-before-migration
    kind: VolumeSnapshot
    apiGroup: snapshot.storage.k8s.io
  accessModes:
    - ReadWriteOnce
  resources:
    requests:
      storage: 100Gi
定期備份計劃
# Recurring snapshot job — every 4 hours, retain 6
apiVersion: longhorn.io/v1beta2
kind: RecurringJob
metadata:
  name: db-snapshot-4h
  namespace: longhorn-system
spec:
  cron: "0 */4 * * *"
  task: snapshot
  retain: 6
  concurrency: 2
  groups:
    - db-volumes
  labels:
    tier: database
---
# Recurring backup job — daily at 02:00, retain 14 days
apiVersion: longhorn.io/v1beta2
kind: RecurringJob
metadata:
  name: db-backup-daily
  namespace: longhorn-system
spec:
  cron: "0 2 * * *"
  task: backup
  retain: 14
  concurrency: 2
  groups:
    - db-volumes
  labels:
    tier: database
---
# Recurring backup job — weekly full, retain 8 weeks
apiVersion: longhorn.io/v1beta2
kind: RecurringJob
metadata:
  name: db-backup-weekly
  namespace: longhorn-system
spec:
  cron: "0 3 * * 0"
  task: backup
  retain: 8
  concurrency: 1
  groups:
    - db-volumes
  labels:
    tier: database
---
# Assign recurring jobs to a volume via labels
# Label the PVC or volume with: recurring-job-group.longhorn.io/db-volumes: enabled
kubectl label pvc pg-data-postgresql-0 -n database \
  recurring-job-group.longhorn.io/db-volumes=enabled
災難恢復
Longhorn 透過DR 卷提供內建災難恢復機制。是輔助叢集中的備用卷,持續從主叢集的備份目標中提取增量備份。當災難發生時,您啟用災難恢復卷,它會變成常規讀寫卷,讓輔助叢集接管。
設定 DR 卷
# On the DR cluster: create a DR volume from the primary's backup
# This is done via the Longhorn UI or API

# 1. Configure the DR cluster's backup target to point to the same S3 bucket
kubectl -n longhorn-system edit settings.longhorn.io backup-target
# value: s3://longhorn-backups@eu-west-1/

# 2. Create a DR volume from the latest backup
# Via Longhorn UI: Backup → Select volume → Create DR Volume
# Via kubectl:
apiVersion: longhorn.io/v1beta2
kind: Volume
metadata:
  name: pg-data-dr
  namespace: longhorn-system
spec:
  size: "107374182400"  # 100Gi in bytes
  numberOfReplicas: 3
  fromBackup: "s3://longhorn-backups@eu-west-1/?backup=backup-abc123&volume=pg-data"
  standby: true
  frontend: ""

# 3. The DR volume auto-syncs incremental backups from S3
# Monitor sync status:
kubectl -n longhorn-system get volumes.longhorn.io pg-data-dr -o jsonpath='{.status.lastBackup}'

# 4. During failover — activate the DR volume:
kubectl -n longhorn-system patch volumes.longhorn.io pg-data-dr \
  --type merge -p '{"spec":{"standby":false,"frontend":"blockdev"}}'

# 5. Create a PVC bound to the activated DR volume
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: pg-data-postgresql-0
  namespace: database
spec:
  storageClassName: longhorn-db
  volumeName: pg-data-dr
  accessModes:
    - ReadWriteOnce
  resources:
    requests:
      storage: 100Gi
卷加密
Longhorn 支援使用 Linux LUKS2 的卷級加密。加密卷保護底層磁碟上的靜態資料 - 即使有人獲得對伺服器儲存的物理訪問許可權,如果沒有加密金鑰,他們也無法讀取卷資料。
# Create a Kubernetes secret with the encryption passphrase
kubectl create secret generic longhorn-crypto \
  -n longhorn-system \
  --from-literal=CRYPTO_KEY_VALUE="a-very-long-and-random-passphrase-here" \
  --from-literal=CRYPTO_KEY_PROVIDER=secret \
  --from-literal=CRYPTO_KEY_CIPHER=aes-xts-plain64 \
  --from-literal=CRYPTO_KEY_HASH=sha256 \
  --from-literal=CRYPTO_KEY_SIZE=256 \
  --from-literal=CRYPTO_PBKDF=argon2i

# StorageClass with encryption enabled
apiVersion: storage.k8s.io/v1
kind: StorageClass
metadata:
  name: longhorn-encrypted
provisioner: driver.longhorn.io
allowVolumeExpansion: true
reclaimPolicy: Retain
parameters:
  numberOfReplicas: "3"
  staleReplicaTimeout: "2880"
  fromBackup: ""
  encrypted: "true"
  csi.storage.k8s.io/provisioner-secret-name: longhorn-crypto
  csi.storage.k8s.io/provisioner-secret-namespace: longhorn-system
  csi.storage.k8s.io/node-publish-secret-name: longhorn-crypto
  csi.storage.k8s.io/node-publish-secret-namespace: longhorn-system
  csi.storage.k8s.io/node-stage-secret-name: longhorn-crypto
  csi.storage.k8s.io/node-stage-secret-namespace: longhorn-system
ReadWriteMany (RWX) 支援
預設情況下,Longhorn 卷是 ReadWriteOnce (RWO) — 它們可以由單個節點上的單個 Pod 掛載。對於需要跨多個 Pod 共享儲存的工作負載(例如,共享媒體上傳、配置檔案、ML 模型工件),Longhorn 透過整合 NFS 伺服器支援 ReadWriteMany (RWX)。
當 PVC 請求 RWX 訪問模式時,Longhorn 會自動部署一個共享管理器 Pod,該 Pod 執行由 Longhorn 卷支援的 NFS 伺服器。然後,多個 Pod 可以透過 NFS 同時掛載該卷。這比部署單獨的 NFS 伺服器更簡單,但與直接塊訪問相比增加了一層網路開銷。
# PVC with ReadWriteMany access mode
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: shared-media
  namespace: application
spec:
  storageClassName: longhorn-rwx
  accessModes:
    - ReadWriteMany
  resources:
    requests:
storage: 50Gi資料庫工作負載
在 Longhorn 上執行資料庫需要仔細注意 StorageClass 引數、pod 關聯性和備份整合。 Longhorn 的每卷引擎和同步複製使其非常適合資料庫工作負載,但您需要正確配置它才能獲得生產級的效能和可靠性。
PostgreSQL StatefulSet 與 Longhorn
# PostgreSQL StatefulSet using Longhorn PVC
apiVersion: apps/v1
kind: StatefulSet
metadata:
  name: postgresql
  namespace: database
spec:
  serviceName: postgresql
  replicas: 3
  selector:
    matchLabels:
      app: postgresql
  template:
    metadata:
      labels:
        app: postgresql
    spec:
      terminationGracePeriodSeconds: 120
      securityContext:
        fsGroup: 999
        runAsUser: 999
      containers:
        - name: postgresql
          image: postgres:16-alpine
          ports:
            - containerPort: 5432
          env:
            - name: POSTGRES_DB
              value: production
            - name: POSTGRES_USER
              valueFrom:
                secretKeyRef:
                  name: pg-credentials
                  key: username
            - name: POSTGRES_PASSWORD
              valueFrom:
                secretKeyRef:
                  name: pg-credentials
                  key: password
            - name: PGDATA
              value: /var/lib/postgresql/data/pgdata
          resources:
            requests:
              cpu: "1"
              memory: 2Gi
            limits:
              cpu: "4"
              memory: 8Gi
          volumeMounts:
            - name: pg-data
              mountPath: /var/lib/postgresql/data
          livenessProbe:
            exec:
              command: ["pg_isready", "-U", "$(POSTGRES_USER)"]
            initialDelaySeconds: 30
            periodSeconds: 10
          readinessProbe:
            exec:
              command: ["pg_isready", "-U", "$(POSTGRES_USER)"]
            initialDelaySeconds: 5
            periodSeconds: 5
  volumeClaimTemplates:
    - metadata:
        name: pg-data
        labels:
          recurring-job-group.longhorn.io/db-volumes: enabled
      spec:
        storageClassName: longhorn-db
        accessModes:
          - ReadWriteOnce
        resources:
          requests:
            storage: 100Gi
MySQL StatefulSet 與 Longhorn
# MySQL StatefulSet using Longhorn PVC
apiVersion: apps/v1
kind: StatefulSet
metadata:
  name: mysql
  namespace: database
spec:
  serviceName: mysql
  replicas: 3
  selector:
    matchLabels:
      app: mysql
  template:
    metadata:
      labels:
        app: mysql
    spec:
      terminationGracePeriodSeconds: 60
      containers:
        - name: mysql
          image: mysql:8.0
          ports:
            - containerPort: 3306
          env:
            - name: MYSQL_ROOT_PASSWORD
              valueFrom:
                secretKeyRef:
                  name: mysql-credentials
                  key: root-password
            - name: MYSQL_DATABASE
              value: production
          args:
            - "--default-authentication-plugin=mysql_native_password"
            - "--innodb-buffer-pool-size=4G"
            - "--innodb-log-file-size=1G"
            - "--innodb-flush-log-at-trx-commit=1"
            - "--sync-binlog=1"
          resources:
            requests:
              cpu: "1"
              memory: 4Gi
            limits:
              cpu: "4"
              memory: 8Gi
          volumeMounts:
            - name: mysql-data
              mountPath: /var/lib/mysql
  volumeClaimTemplates:
    - metadata:
        name: mysql-data
        labels:
          recurring-job-group.longhorn.io/db-volumes: enabled
      spec:
        storageClassName: longhorn-db
        accessModes:
          - ReadWriteOnce
        resources:
          requests:
storage: 200Gi效能調整
Longhorn 在應用程式和物理磁碟之間新增了一個儲存複製層,與直接本地磁碟訪問相比,這會引入一些延遲。對於大多數工作負載來說,這種開銷可以忽略不計,但具有大量寫入模式的資料庫工作負載需要進行調整才能實現最佳效能。
使用資料區域性性:盡力而為。這可確保一個副本與資料庫 Pod 位於同一節點上,這意味著讀取會以 NVMe/SSD 速度命中本地磁碟。寫入仍會複製到遠端節點,但本地副本消除了讀取的網路往返。
專用於 Longhorn 的磁碟。不要與 Longhorn 資料共享作業系統磁碟。 新增專用 NVMe 或 SSD 驅動器並將其配置為 Longhorn 磁碟。這可以防止作業系統和資料庫卷之間的 I/O 爭用。
# Configure dedicated disks on a node
# Via kubectl (Longhorn node CRD)
kubectl -n longhorn-system edit nodes.longhorn.io worker-01

# Add the dedicated disk under spec.disks:
spec:
  disks:
    default-disk:
      allowScheduling: false  # disable OS disk for Longhorn
      path: /var/lib/longhorn/
      storageReserved: 0
    nvme-data:
      allowScheduling: true
      path: /mnt/nvme-longhorn/
      storageReserved: 10737418240  # 10Gi reserved
      tags:
        - nvme
        - database
設定有保證的引擎管理器 CPU。Longhorn 的引擎程序使用 CPU 進行 I/O 處理和複製。guaranteedInstanceManagerCPU設定為 Longhorn 例項管理器保留一定比例的節點 CPU,以防止 CPU 在負載下飢餓。
調整副本計數。對於已經具有應用程式級複製(PostgreSQL 流複製、MySQL 組複製、MongoDB 副本集)的資料庫,您可以將 Longhorn 副本數量減少到 2 個,而不是 3 個。資料庫自身的複製提供了額外的資料保護層,更少的 Longhorn 副本意味著更少的寫入放大和更好的寫入吞吐量。
使用 ext4 而非 xfs 來實現小型隨機 I/O。雖然 xfs 在大型順序寫入方面表現出色,但 ext4 通常在資料庫工作負載典型的小型隨機 I/O 模式方面表現更好。在您的 StorageClass 中設定fsType: ext4。
節點排程和磁碟管理
Longhorn 提供對用於卷排程的節點和磁碟的細粒度控制。這在異構叢集中至關重要,其中一些節點具有快速 NVMe 儲存,而其他節點具有較慢的 SATA 驅動器。
# Tag nodes for storage scheduling
kubectl label node worker-01 node.longhorn.io/storage=nvme
kubectl label node worker-02 node.longhorn.io/storage=nvme
kubectl label node worker-03 node.longhorn.io/storage=nvme
kubectl label node worker-04 node.longhorn.io/storage=sata

# Use node selector in StorageClass to target NVMe nodes
apiVersion: storage.k8s.io/v1
kind: StorageClass
metadata:
  name: longhorn-nvme
provisioner: driver.longhorn.io
allowVolumeExpansion: true
parameters:
  numberOfReplicas: "3"
  nodeSelector: "node.longhorn.io/storage=nvme"
  diskSelector: "nvme,database"
  dataLocality: best-effort
使用 Prometheus 和 Grafana 進行監控
Longhorn 透過內建指標端點公開 Prometheus 指標。監控這些指標對於容量規劃、效能分析和主動警報至關重要。
# ServiceMonitor for Longhorn metrics
apiVersion: monitoring.coreos.com/v1
kind: ServiceMonitor
metadata:
  name: longhorn-prometheus
  namespace: monitoring
  labels:
    release: prometheus
spec:
  selector:
    matchLabels:
      app: longhorn-manager
  namespaceSelector:
    matchNames:
      - longhorn-system
  endpoints:
    - port: manager
      path: /metrics
      interval: 30s
---
# PrometheusRule for Longhorn alerts
apiVersion: monitoring.coreos.com/v1
kind: PrometheusRule
metadata:
  name: longhorn-alerts
  namespace: monitoring
spec:
  groups:
    - name: longhorn-storage
      rules:
        - alert: LonghornVolumeStatusCritical
          expr: longhorn_volume_robustness == 3
          for: 5m
          labels:
            severity: critical
          annotations:
            summary: "Longhorn volume {{ $labels.volume }} is Faulted"
        - alert: LonghornVolumeStatusDegraded
          expr: longhorn_volume_robustness == 2
          for: 10m
          labels:
            severity: warning
          annotations:
            summary: "Longhorn volume {{ $labels.volume }} is Degraded"
        - alert: LonghornNodeStorageWarning
          expr: |
            (longhorn_node_storage_usage_bytes / longhorn_node_storage_capacity_bytes) > 0.80
          for: 15m
          labels:
            severity: warning
          annotations:
            summary: "Longhorn node {{ $labels.node }} storage at {{ $value | humanizePercentage }}"
        - alert: LonghornBackupFailed
          expr: longhorn_backup_state == 3
          for: 5m
          labels:
            severity: critical
          annotations:
            summary: "Longhorn backup failed for volume {{ $labels.volume }}"
為 Longhorn 監控建立的關鍵 Grafana 儀表板面板包括:卷 IOPS(讀/寫)、卷吞吐量 (MB/s)、卷延遲 (p50/p95/p99)、副本重建進度、節點儲存容量和使用情況、備份狀態和期限以及每個卷的快照計數。
k3s 叢集,具有完整的 Longhorn 儲存堆疊
下圖顯示了 Longhorn 如何融入完整的 k3s 生產堆疊(從裸機伺服器到應用程式 Pod),並具有 Rancher 管理和 Prometheus/Grafana 可觀察性。
與其他 Kubernetes 儲存解決方案的比較
Longhorn 並不是 Kubernetes 的唯一儲存選項。瞭解它與替代方案的比較有助於您根據您的具體要求做出正確的選擇。
| 功能 | Longhorn | Rook-Ceph | OpenEBS (Mayastor) | 本地路徑 |
|---|---|---|---|---|
| 複雜性 | 低 | 高 | 中 | 最小 |
| 複製 | 內建(2–3 個副本) | CRUSH 演算法 | NVMe-oF 副本 | 無 |
| 動態 PVC 擴充套件 | 有(線上) | 有 | 有 | 無 |
| 快照 | COW 快照 | RBD 快照 | 是 | 否 |
| 備份到雲端 | 內建 (S3/GCS/Azure) | 透過 rbd 匯出 | 透過 Velero | 無 |
| DR 卷 | 本機備用卷 | RBD 映象 | 無 | 無 |
| RWX 支援 | 是(基於 NFS) | 是(CephFS) | 否 | 否 |
| 卷加密 | LUKS2 | dmcrypt | 無 | 無 |
| UI | 內建 Web UI | Ceph 儀表板 | 最小 | 無 |
| 最小節點 | 1(3 個用於 HA) | 3(專用 OSD 節點) | 3 | 1 |
| 資源開銷 | 低-中 | 高 | 中 | 無 |
| 最適合 | k3s/RKE2 生產 | 大型企業 | 高效能 NVMe | 開發/單節點 |
Longhorn 與 Rook-Ceph:Ceph 是更強大的系統 - 它透過複雜的 CRUSH 放置演算法支援物件儲存、檔案儲存和塊儲存。然而,Ceph 需要至少 3 個專用 OSD 節點、大量 RAM(每個 OSD 守護程序至少 4GB)以及深厚的操作專業知識。對於具有 3-10 個節點的 k3s 叢集,Longhorn 以 10% 的運營成本提供 90% 的價值。
Longhorn 與 OpenEBS Mayastor:Mayastor 使用 NVMe-over-Fabrics 進行高效能複製,實現比 Longhorn 基於 TCP 的複製更低的延遲。如果原始 IOPS 和亞毫秒延遲是您最關心的問題,並且您擁有帶 RDMA 網路的 NVMe 基礎設施,那麼 Mayastor 可能是更好的選擇。對於大多數 k3s 部署,Longhorn 的整合備份、災難恢復和操作簡單性超過了 Mayastor 的效能優勢。
Longhorn 與本地路徑:本地路徑配置程式是 k3s 的預設儲存 — 它只是在節點的本地檔案系統上建立目錄。零複製、零快照、零備份整合。這對於開發來說很好,但對於生產資料來說是不可接受的。
生產最佳實踐
這些建議是從執行資料庫工作負載的數十個生產 k3s 叢集中執行 Longhorn 中提煉出來的。
1. 設定例項管理器的資源預留。Longhorn 例項管理器(引擎和副本管理器)需要有保證的 CPU 以避免節點壓力期間 I/O 停頓。在 Longhorn 設定中將guaranteedInstanceManagerCPU設定為至少 12%。
2. 對資料庫卷使用 Retain 回收策略。切勿將Delete用於資料庫 PVC。即使 PVC 被刪除,Retain策略也會保留 PV 及其資料,為您提供防止意外刪除的安全網。
3. 禁用生產副本軟反關聯性。設定replicaSoftAntiAffinity: false以確保副本始終分佈在不同節點上。透過軟反親和力,當空間緊張時,Longhorn 可能會在同一節點上安排多個副本,這違背了複製的目的。
4. 在每個節點上預留儲存空間。將storageMinimalAvailablePercentage設定為至少 15%。這可以防止 Longhorn 消耗所有磁碟空間,從而導致影響所有 Pod 的節點級問題。
5. 啟用自動搶救。當至少一個副本仍然正常時,autoSalvage設定會自動恢復進入故障狀態的卷。這減少了節點故障期間的人工干預。
6. 將優先順序設定為系統叢集關鍵。Longhorn 的管理器和驅動程式元件在節點壓力期間不應被驅逐。將它們的priorityClass 設定為system-cluster-critical以確保它們能夠在 Pod 驅逐中倖存下來。
7. 為所有生產量配置重複作業。每個生產卷都應具有快照和備份重複作業。每 4 小時建立一次快照以實現快速回滾,每天進行一次備份以實現災難恢復。
8. 定期測試 DR 卷啟用。建立每月計劃來啟用備用叢集中的 DR 卷、驗證資料完整性並練習故障轉移過程。從未經過測試的災難恢復計劃只是文件。
9. 主動監控捲執行狀況。針對降級和故障卷、節點儲存容量、備份期限和副本重建狀態設定 Prometheus 警報。當使用者報告資料庫速度緩慢時,儲存問題已經持續了幾個小時。
10. 使用專用儲存磁碟。將 Longhorn 資料與作業系統磁碟分開。這可以防止 I/O 爭用,為您提供更清晰的容量管理,並避免使用 Longhorn 資料填充作業系統磁碟的風險。
特定於雲的部署指南
AWS — 具有 NVMe 例項儲存的 EC2
對於 AWS 部署,請使用附帶 NVMe 例項儲存的i3.xlarge或i3en.xlarge例項。這些以預配置 EBS IOPS 成本的一小部分提供原始 NVMe 效能。格式化例項儲存並將其配置為 Longhorn 磁碟。
# On each EC2 i3.xlarge instance
sudo mkfs.ext4 /dev/nvme0n1
sudo mkdir -p /mnt/longhorn-nvme
sudo mount /dev/nvme0n1 /mnt/longhorn-nvme
echo '/dev/nvme0n1 /mnt/longhorn-nvme ext4 defaults,nofail 0 2' | sudo tee -a /etc/fstab

# Configure as Longhorn disk (via node CRD or UI)
# Path: /mnt/longhorn-nvme/
Azure — 具有超級磁碟
的虛擬機器在 Azure 上,使用具有本地 NVMe 儲存的Standard_L8s_v3或Standard_L16s_v3VM。或者,連線超級磁碟以獲得一致的亞毫秒級延遲。超級磁碟允許您獨立配置 IOPS 和吞吐量。
# Attach Ultra Disk to Azure VM (Azure CLI)
az vm disk attach \
  --vm-name k3s-worker-01 \
  --resource-group k3s-cluster \
  --name longhorn-ultra-01 \
  --size-gb 512 \
  --sku UltraSSD_LRS \
  --disk-iops-read-write 10000 \
  --disk-mbps-read-write 300 \
  --new
GCP — 具有本地 SSD
的虛擬機器GCP 提供連線到n2-standard或c3-standardVM 的本地 SSD。本地 SSD 每盤提供 375 GB 容量,讀取 IOPS 高達 680,000。連線多個本地 SSD 並對它們進行 RAID 以獲得更大的卷。
# Create VM with local SSDs (gcloud)
gcloud compute instances create k3s-worker-01 \
  --machine-type=n2-standard-8 \
  --local-ssd=interface=NVME \
  --local-ssd=interface=NVME \
  --zone=europe-west1-b

# RAID two local SSDs for 750GB Longhorn disk
sudo mdadm --create /dev/md0 --level=0 --raid-devices=2 /dev/nvme0n1 /dev/nvme0n2
sudo mkfs.ext4 /dev/md0
sudo mkdir -p /mnt/longhorn-nvme
sudo mount /dev/md0 /mnt/longhorn-nvme
本地資料中心
對於本地部署,請使用配備 Longhorn 專用 NVMe 或 SAS SSD 驅動器的伺服器。將作業系統磁碟與儲存磁碟分開。 在節點之間使用 10GbE 或 25GbE 網路可確保複製流量不會成為瓶頸 — Longhorn 同步複製生成的網路流量與寫入吞吐量乘以副本數量成正比。
# Typical on-premises server spec for Longhorn k3s node
# CPU: 8+ cores (Xeon or EPYC)
# RAM: 32+ GB
# OS Disk: 256GB SATA SSD (mirrored)
# Longhorn Disk: 2x 1TB NVMe (RAID-1 or individual Longhorn disks)
# Network: 2x 25GbE (bonded, one for application, one for storage)

# Configure dedicated storage network (optional but recommended)
# In Longhorn settings:
# storage-network: kube-system/storage-network-attachment
Longhorn UI 演練
Longhorn 附帶內建 Web UI,提供用於管理卷、快照、備份、節點和設定的視覺化介面。透過安裝期間配置的 Ingress 或透過 kubectl port-forward 訪問它。
# Quick access via port-forward
kubectl -n longhorn-system port-forward svc/longhorn-frontend 8080:80
# Open http://localhost:8080 in your browser
UI 提供了多個關鍵檢視:儀表板顯示叢集範圍的儲存執行狀況,包括總容量、已用空間和卷狀態。卷列出所有卷及其狀態(正常/降級/故障)、大小、副本計數和連線的節點。您可以直接從此檢視擴充套件、快照、備份和還原卷。節點顯示每個節點的儲存配置、磁碟分配和排程狀態。備份列出備份目標中儲存的所有備份及其卷、大小和建立時間。設定公開所有 Longhorn 配置引數及其說明。
常見問題故障排除
降級卷
當一個或多個副本執行狀況不佳但卷仍可執行時,卷將進入降級狀態。常見原因包括節點故障、磁碟已滿或網路分割槽。
# Check volume status
kubectl -n longhorn-system get volumes.longhorn.io -o wide

# Describe the volume for detailed status
kubectl -n longhorn-system describe volumes.longhorn.io pvc-abc123

# Check replica status
kubectl -n longhorn-system get replicas.longhorn.io -l longhornvolume=pvc-abc123

# If a replica is stuck in error state, delete it to trigger rebuild
kubectl -n longhorn-system delete replicas.longhorn.io pvc-abc123-r-12345

# Monitor rebuild progress
kubectl -n longhorn-system get volumes.longhorn.io pvc-abc123 \
  -o jsonpath='{.status.conditions}' | jq
卷卡在連線/拆卸
中# Check engine status
kubectl -n longhorn-system get engines.longhorn.io -l longhornvolume=pvc-abc123
# Check for stuck VolumeAttachment objects
kubectl get volumeattachments | grep pvc-abc123
# Force detach a stuck volume (use cautiously)
kubectl -n longhorn-system patch volumes.longhorn.io pvc-abc123 \
--type merge -p '{"spec":{"nodeID":""}}'
# If attachment is truly stuck, delete the VolumeAttachment
kubectl delete volumeattachment csi-abc123def456空間壓力
# Check node storage usage
kubectl -n longhorn-system get nodes.longhorn.io -o wide

# Identify large snapshots consuming space
kubectl -n longhorn-system get snapshots.longhorn.io -l longhornvolume=pvc-abc123

# Purge old snapshots to reclaim space
# Via Longhorn UI: Volume → Snapshots → Delete unneeded snapshots
# Old snapshots consume space because COW data cannot be freed until the snapshot is deleted

# Check for snapshot data integrity issues
kubectl -n longhorn-system get settings.longhorn.io snapshot-data-integrity
升級程式
Longhorn 升級應謹慎執行,因為儲存系統支撐著所有有狀態工作負載。升級前務必備份所有關鍵卷。
# 1. Back up all volumes before upgrade
for vol in $(kubectl -n longhorn-system get volumes.longhorn.io -o jsonpath='{.items[*].metadata.name}'); do
  echo "Backing up $vol"
  kubectl -n longhorn-system patch volumes.longhorn.io $vol \
    --type merge -p '{"spec":{"lastBackupAt":"'$(date -u +"%Y-%m-%dT%H:%M:%SZ")'"}}'
done

# 2. Check current version
kubectl -n longhorn-system get daemonset longhorn-manager -o jsonpath='{.spec.template.spec.containers[0].image}'

# 3. Upgrade via Helm
helm repo update
helm upgrade longhorn longhorn/longhorn \
  --namespace longhorn-system \
  --version 1.7.2 \
  --values longhorn-values.yaml

# 4. Monitor the rolling upgrade
kubectl -n longhorn-system rollout status daemonset/longhorn-manager
kubectl -n longhorn-system rollout status deployment/longhorn-driver-deployer

# 5. Verify all volumes are healthy after upgrade
kubectl -n longhorn-system get volumes.longhorn.io -o custom-columns=NAME:.metadata.name,STATE:.status.state,ROBUSTNESS:.status.robustness

# 6. Longhorn automatically upgrades engines — monitor progress
kubectl -n longhorn-system get engines.longhorn.io -o wide
與資料庫操作員整合
現代 Kubernetes 資料庫運算子(CloudNativePG、Percona Operator、Zalando Postgres Operator)與 Longhorn 無縫協作。 Operator 管理資料庫生命週期,而 Longhorn 為底層儲存提供複製、快照和備份。
# CloudNativePG cluster using Longhorn storage
apiVersion: postgresql.cnpg.io/v1
kind: Cluster
metadata:
  name: production-pg
  namespace: database
spec:
  instances: 3
  storage:
    size: 100Gi
    storageClass: longhorn-db
    pvcTemplate:
      accessModes:
        - ReadWriteOnce
      resources:
        requests:
          storage: 100Gi
  walStorage:
    size: 20Gi
    storageClass: longhorn-fast

  postgresql:
    parameters:
      shared_buffers: "2GB"
      effective_cache_size: "6GB"
      maintenance_work_mem: "512MB"
      wal_buffers: "64MB"
      max_connections: "200"

  backup:
    barmanObjectStore:
      destinationPath: s3://pg-backups/cnpg/
      endpointURL: https://s3.eu-west-1.amazonaws.com
      s3Credentials:
        accessKeyId:
          name: aws-creds
          key: ACCESS_KEY_ID
        secretAccessKey:
          name: aws-creds
          key: SECRET_ACCESS_KEY
      wal:
        compression: gzip
    retentionPolicy: "30d"

  resources:
    requests:
      cpu: "2"
      memory: 4Gi
    limits:
      cpu: "4"
      memory: 8Gi
# Percona XtraDB Cluster with Longhorn storage
apiVersion: pxc.percona.com/v1
kind: PerconaXtraDBCluster
metadata:
name: production-mysql
namespace: database
spec:
crVersion: "1.14.0"
pxc:
size: 3
image: percona/percona-xtradb-cluster:8.0
resources:
requests:
cpu: "2"
memory: 4Gi
volumeSpec:
persistentVolumeClaim:
storageClassName: longhorn-db
accessModes:
- ReadWriteOnce
resources:
requests:
storage: 200Gi
backup:
image: percona/percona-xtradb-cluster-operator:1.14.0-pxc8.0-backup-pxb8.0.35
storages:
s3-backup:
type: s3
s3:
bucket: mysql-backups
region: eu-west-1
credentialsSecret: aws-creds
schedule:
- name: daily-full
schedule: "0 2 * * *"
keep: 14
storageName: s3-backup結論
Longhorn 將 k3s 從僅適用於邊緣和開發的輕量級 Kubernetes 發行版轉變為能夠執行任務關鍵型有狀態工作負載的生產就緒平臺。其架構 — 每卷引擎、同步多節點複製、整合快照和備份到雲物件儲存、災難恢復卷、卷加密和線上 PVC 擴充套件 — 提供企業級儲存,但沒有企業級複雜性。
Longhorn 在生產中取得成功的關鍵有三個。首先,從一開始就正確配置:使用專用儲存磁碟,設定適當的複製因子和資料區域性性,併為不同的工作負載型別建立專用的儲存類。其次,從第一天起就將備份整合到您的架構中:用於快速回滾的定期快照、用於災難恢復的每日備份到 S3/GCS/Azure 以及用於最壞情況的備用叢集中的 DR 卷。第三,監控一切:卷健康狀況、節點儲存容量、備份期限和副本重建狀態——儲存問題在變得災難性之前是不可見的。
動態 PVC 擴充套件消除了最常見的生產事故來源之一——磁碟空間不足。藉助 Longhorn,只需一條 kubectl 命令即可將資料庫卷從 50Gi 擴充套件到 500Gi,且停機時間為零。 結合容量閾值的 Prometheus 警報,您可以在卷變得關鍵之前主動擴充套件卷,或者完全自動化擴充套件。
無論您是在 k3s 上執行 PostgreSQL、MySQL、MongoDB 還是 Redis(在裸機伺服器、AWS EC2、Azure 虛擬機器、GCP 例項還是本地資料中心硬體上),Longhorn 都能提供儲存基礎,讓您能夠專注於應用程式,而不必擔心資料永續性。安裝它、配置它、監控它,並用您的生產資料信任它。