 Balinder Walia
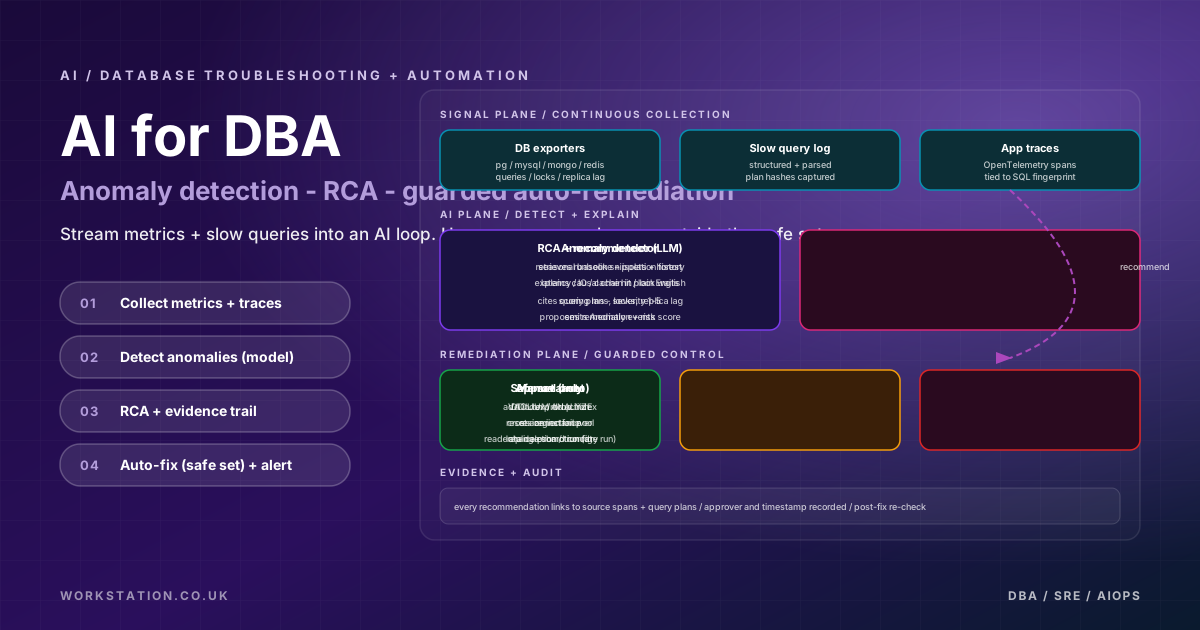
現代生產資料庫每分鐘生成數百萬個指標——查詢延遲、鎖爭用、複製延遲、緩衝池命中率和連線池耗盡。傳統的基於閾值的警報使團隊陷入誤報中,同時錯過了災難性故障之前的微妙退化模式。人工智慧和機器學習透過學習正常行為、在級聯之前檢測異常、自動最佳化查詢以及在無需人工干預的情況下執行修復,從根本上改變了這一方程式。本指南涵蓋了 MySQL、PostgreSQL、MongoDB、Redis 和 Couchbase 中人工智慧驅動的資料庫故障排除的全部內容。
AI資料庫監控管道
在深入研究特定技術之前,瞭解人工智慧驅動的資料庫監控系統的端到端架構至關重要。該管道從每個資料庫引擎收集原始指標,將其儲存在時間序列資料庫中,透過 ML 模型提供資料以進行異常檢測,透過智慧警報管理器路由警報,並在滿足置信閾值時觸發自動修復操作。
用於資料庫監控和可觀察性的 AI/ML
傳統資料庫監控依賴於靜態閾值:當 CPU 超過 80%、查詢延遲超過 500 毫秒或連線計數超過 200 時發出警報。這種方法在動態生產環境中會發生災難性的失敗,因為正常情況會隨一天中的時間、一週中的某一天、季節性模式和部署事件而變化。人工智慧驅動的可觀察性用不斷適應的學習基線取代了這些嚴格的閾值。
收集正確的指標
任何人工智慧監控系統的基礎都是全面的指標收集。每個資料庫引擎都會公開對效能至關重要的獨特指標:
# prometheus_db_collector.py — Unified metric collector for multi-DB environments
import prometheus_client as prom
import mysql.connector
import psycopg2
import pymongo
import redis
from couchbase.cluster import Cluster
from couchbase.options import ClusterOptions
from couchbase.auth import PasswordAuthenticator
import time
import logging

logger = logging.getLogger(__name__)

# MySQL metrics
mysql_slow_queries = prom.Gauge('mysql_slow_queries_total', 'Total slow queries')
mysql_buffer_pool_hit = prom.Gauge('mysql_innodb_buffer_pool_hit_ratio', 'Buffer pool hit ratio')
mysql_deadlocks = prom.Counter('mysql_deadlocks_total', 'Total deadlocks detected')
mysql_repl_lag = prom.Gauge('mysql_replication_lag_seconds', 'Replication lag in seconds')
mysql_active_connections = prom.Gauge('mysql_active_connections', 'Current active connections')
mysql_threads_running = prom.Gauge('mysql_threads_running', 'Currently running threads')

# PostgreSQL metrics
pg_bloat_ratio = prom.Gauge('pg_table_bloat_ratio', 'Table bloat ratio', ['table_name'])
pg_vacuum_age = prom.Gauge('pg_vacuum_age_seconds', 'Seconds since last vacuum', ['table_name'])
pg_index_hit_ratio = prom.Gauge('pg_index_hit_ratio', 'Index hit ratio')
pg_wal_rate = prom.Gauge('pg_wal_bytes_per_second', 'WAL generation rate')
pg_active_locks = prom.Gauge('pg_active_locks', 'Number of active locks', ['lock_type'])

# MongoDB metrics
mongo_opcounters = prom.Gauge('mongo_opcounters', 'Operation counters', ['op_type'])
mongo_wiredtiger_cache = prom.Gauge('mongo_wiredtiger_cache_usage_pct', 'WiredTiger cache usage')
mongo_repl_lag = prom.Gauge('mongo_replication_lag_seconds', 'Replica set lag')

# Redis metrics
redis_memory_frag = prom.Gauge('redis_memory_fragmentation_ratio', 'Memory fragmentation ratio')
redis_evicted_keys = prom.Counter('redis_evicted_keys_total', 'Total evicted keys')
redis_keyspace_hitrate = prom.Gauge('redis_keyspace_hit_ratio', 'Keyspace hit ratio')


class UnifiedDBCollector:
    def __init__(self, config):
        self.config = config
        self.connections = {}

    def collect_mysql(self):
        conn = mysql.connector.connect(**self.config['mysql'])
        cursor = conn.cursor(dictionary=True)

        cursor.execute("SHOW GLOBAL STATUS LIKE 'Slow_queries'")
        row = cursor.fetchone()
        mysql_slow_queries.set(int(row['Value']))

        cursor.execute("""
            SELECT
                (1 - (Innodb_buffer_pool_reads / Innodb_buffer_pool_read_requests)) * 100
            AS hit_ratio FROM (
                SELECT
                    VARIABLE_VALUE AS Innodb_buffer_pool_reads
                FROM performance_schema.global_status
                WHERE VARIABLE_NAME = 'Innodb_buffer_pool_reads'
            ) a, (
                SELECT
                    VARIABLE_VALUE AS Innodb_buffer_pool_read_requests
                FROM performance_schema.global_status
                WHERE VARIABLE_NAME = 'Innodb_buffer_pool_read_requests'
            ) b
        """)
        result = cursor.fetchone()
        mysql_buffer_pool_hit.set(float(result['hit_ratio']))

        cursor.execute("SHOW GLOBAL STATUS LIKE 'Innodb_deadlocks'")
        row = cursor.fetchone()
        mysql_deadlocks.inc(int(row['Value']))

        cursor.execute("SHOW SLAVE STATUS")
        slave = cursor.fetchone()
        if slave and slave.get('Seconds_Behind_Master') is not None:
            mysql_repl_lag.set(float(slave['Seconds_Behind_Master']))

        cursor.execute("SHOW GLOBAL STATUS LIKE 'Threads_connected'")
        row = cursor.fetchone()
        mysql_active_connections.set(int(row['Value']))

        cursor.close()
        conn.close()

    def collect_postgresql(self):
        conn = psycopg2.connect(**self.config['postgresql'])
        cursor = conn.cursor()

        cursor.execute("""
            SELECT schemaname, tablename,
                   pg_total_relation_size(schemaname || '.' || tablename) as total_size,
                   pg_relation_size(schemaname || '.' || tablename) as table_size
            FROM pg_tables
            WHERE schemaname = 'public'
        """)
        for row in cursor.fetchall():
            if row[3] > 0:
                bloat = (row[2] - row[3]) / row[2]
                pg_bloat_ratio.labels(table_name=row[1]).set(bloat)

        cursor.execute("""
            SELECT relname, extract(epoch from now() - last_vacuum) as vacuum_age
            FROM pg_stat_user_tables
            WHERE last_vacuum IS NOT NULL
        """)
        for row in cursor.fetchall():
            pg_vacuum_age.labels(table_name=row[0]).set(row[1])

        cursor.execute("""
            SELECT sum(heap_blks_hit) / nullif(sum(heap_blks_hit) + sum(heap_blks_read), 0)
            FROM pg_statio_user_tables
        """)
        result = cursor.fetchone()
        if result[0]:
            pg_index_hit_ratio.set(float(result[0]))

        cursor.close()
        conn.close()

    def collect_mongodb(self):
        client = pymongo.MongoClient(self.config['mongodb']['uri'])
        status = client.admin.command('serverStatus')

        for op in ['insert', 'query', 'update', 'delete']:
            mongo_opcounters.labels(op_type=op).set(status['opcounters'][op])

        cache = status['wiredTiger']['cache']
        cache_used = cache['bytes currently in the cache']
        cache_max = cache['maximum bytes configured']
        mongo_wiredtiger_cache.set((cache_used / cache_max) * 100)

        client.close()

    def collect_redis(self):
        r = redis.Redis(**self.config['redis'])
        info = r.info()

        redis_memory_frag.set(info.get('mem_fragmentation_ratio', 0))
        redis_evicted_keys.inc(info.get('evicted_keys', 0))

        hits = info.get('keyspace_hits', 0)
        misses = info.get('keyspace_misses', 0)
        if hits + misses > 0:
            redis_keyspace_hitrate.set(hits / (hits + misses))

        r.close()

    def run(self, interval=15):
        prom.start_http_server(9100)
        logger.info('Metric collector started on :9100')
        while True:
            try:
                self.collect_mysql()
                self.collect_postgresql()
                self.collect_mongodb()
                self.collect_redis()
            except Exception as e:
                logger.error(f'Collection error: {e}')
            time.sleep(interval)
透過時間序列分析進行異常檢測
人工智慧在資料庫監控中的核心價值主張是異常檢測——識別偏離學習基線的異常模式。三種主要演算法主導了這個領域:用於季節性分解的 Facebook Prophet、用於複雜時間模式的 LSTM 網路以及用於多元異常值檢測的隔離森林。
使用 scikit-learn 和 Prophet 實施異常檢測
以下 Python 實現演示了一個可立即投入生產的異常檢測器,它將用於多變數檢測的隔離森林與用於時間序列預測的 Prophet 結合起來。這種雙重方法可以捕獲突然的尖峰和逐漸的漂移。
# anomaly_detector.py — Production anomaly detection for database metrics
import numpy as np
import pandas as pd
from sklearn.ensemble import IsolationForest
from sklearn.preprocessing import StandardScaler
from prophet import Prophet
from prometheus_api_client import PrometheusConnect
from datetime import datetime, timedelta
import warnings
import json
import logging

warnings.filterwarnings('ignore')
logger = logging.getLogger(__name__)


class DatabaseAnomalyDetector:
    def __init__(self, prometheus_url, contamination=0.05):
        self.prom = PrometheusConnect(url=prometheus_url, disable_ssl=True)
        self.scaler = StandardScaler()
        self.isolation_forest = IsolationForest(
            contamination=contamination,
            n_estimators=200,
            max_samples='auto',
            random_state=42,
            n_jobs=-1
        )
        self.prophet_models = {}
        self.baseline_stats = {}

    def fetch_metrics(self, query, hours=168):
        """Fetch metric data from Prometheus for the given time window."""
        end_time = datetime.now()
        start_time = end_time - timedelta(hours=hours)
        result = self.prom.custom_query_range(
            query=query,
            start_time=start_time,
            end_time=end_time,
            step='60s'
        )
        if not result:
            return pd.DataFrame()

        timestamps, values = [], []
        for point in result[0]['values']:
            timestamps.append(datetime.fromtimestamp(float(point[0])))
            values.append(float(point[1]))

        return pd.DataFrame({'timestamp': timestamps, 'value': values})

    def train_isolation_forest(self, metrics_dict):
        """Train Isolation Forest on multiple metric dimensions."""
        frames = []
        for name, df in metrics_dict.items():
            if not df.empty:
                series = df.set_index('timestamp')['value'].rename(name)
                frames.append(series)

        if not frames:
            raise ValueError('No metric data available for training')

        combined = pd.concat(frames, axis=1).dropna()
        scaled = self.scaler.fit_transform(combined)
        self.isolation_forest.fit(scaled)

        self.baseline_stats = {
            col: {'mean': combined[col].mean(), 'std': combined[col].std()}
            for col in combined.columns
        }
        logger.info(f'Isolation Forest trained on {len(combined)} samples, {len(frames)} features')
        return combined

    def train_prophet(self, metric_name, df):
        """Train a Prophet model for seasonal time-series forecasting."""
        if df.empty:
            return
        prophet_df = df.rename(columns={'timestamp': 'ds', 'value': 'y'})
        model = Prophet(
            changepoint_prior_scale=0.05,
            seasonality_prior_scale=10,
            holidays_prior_scale=10,
            daily_seasonality=True,
            weekly_seasonality=True,
            yearly_seasonality=False,
            interval_width=0.95
        )
        model.fit(prophet_df)
        self.prophet_models[metric_name] = model
        logger.info(f'Prophet model trained for {metric_name}')

    def detect_anomalies_multivariate(self, current_metrics):
        """Detect anomalies using Isolation Forest across multiple metrics."""
        scaled = self.scaler.transform(current_metrics)
        predictions = self.isolation_forest.predict(scaled)
        scores = self.isolation_forest.decision_function(scaled)

        anomalies = []
        for i, (pred, score) in enumerate(zip(predictions, scores)):
            if pred == -1:
                anomaly_score = max(0, min(1, 0.5 - score))
                anomalies.append({
                    'index': i,
                    'score': round(anomaly_score, 4),
                    'severity': 'critical' if anomaly_score > 0.8 else 'warning',
                    'values': current_metrics.iloc[i].to_dict()
                })
        return anomalies

    def detect_anomalies_timeseries(self, metric_name, df):
        """Detect anomalies using Prophet forecast bounds."""
        model = self.prophet_models.get(metric_name)
        if not model or df.empty:
            return []

        prophet_df = df.rename(columns={'timestamp': 'ds', 'value': 'y'})
        forecast = model.predict(prophet_df[['ds']])
        merged = prophet_df.merge(forecast[['ds', 'yhat', 'yhat_lower', 'yhat_upper']], on='ds')

        anomalies = []
        for _, row in merged.iterrows():
            if row['y'] < row['yhat_lower'] or row['y'] > row['yhat_upper']:
                deviation = abs(row['y'] - row['yhat'])
                band = row['yhat_upper'] - row['yhat_lower']
                severity_score = min(1.0, deviation / band) if band > 0 else 0.5
                anomalies.append({
                    'timestamp': str(row['ds']),
                    'actual': round(row['y'], 4),
                    'predicted': round(row['yhat'], 4),
                    'lower': round(row['yhat_lower'], 4),
                    'upper': round(row['yhat_upper'], 4),
                    'score': round(severity_score, 4),
                    'severity': 'critical' if severity_score > 0.8 else 'warning'
                })
        return anomalies

    def run_full_analysis(self, db_type='mysql'):
        """Run complete anomaly detection pipeline for a database type."""
        metric_queries = {
            'mysql': {
                'cpu': 'rate(process_cpu_seconds_total{job="mysql"}[5m])',
                'connections': 'mysql_global_status_threads_connected',
                'slow_queries': 'rate(mysql_global_status_slow_queries[5m])',
                'buffer_pool_hit': 'mysql_global_status_innodb_buffer_pool_hit_ratio',
                'repl_lag': 'mysql_slave_status_seconds_behind_master'
            },
            'postgresql': {
                'cpu': 'rate(process_cpu_seconds_total{job="postgres"}[5m])',
                'connections': 'pg_stat_activity_count',
                'cache_hit': 'pg_stat_database_blks_hit / (pg_stat_database_blks_hit + pg_stat_database_blks_read)',
                'deadlocks': 'rate(pg_stat_database_deadlocks[5m])',
                'wal_rate': 'rate(pg_wal_lsn_diff[5m])'
            }
        }

        queries = metric_queries.get(db_type, metric_queries['mysql'])
        metrics = {}
        for name, query in queries.items():
            metrics[name] = self.fetch_metrics(query)

        self.train_isolation_forest(metrics)
        for name, df in metrics.items():
            self.train_prophet(name, df)

        results = {'db_type': db_type, 'anomalies': [], 'summary': {}}
        for name, df in metrics.items():
            ts_anomalies = self.detect_anomalies_timeseries(name, df)
            if ts_anomalies:
                results['anomalies'].extend([
                    {**a, 'metric': name} for a in ts_anomalies
                ])

        results['summary'] = {
            'total_anomalies': len(results['anomalies']),
            'critical': sum(1 for a in results['anomalies'] if a['severity'] == 'critical'),
            'warning': sum(1 for a in results['anomalies'] if a['severity'] == 'warning')
        }
        return results


if __name__ == '__main__':
    detector = DatabaseAnomalyDetector('http://prometheus:9090')
    results = detector.run_full_analysis('mysql')
    print(json.dumps(results, indent=2))
預測性警報與基於閾值的警報
傳統的基於閾值的警報存在兩種相反的故障模式。將閾值設定得太緊,在正常負載變化期間您就會陷入誤報中。將它們設定得太鬆,您就會錯過真正的降級,直到完全中斷。預測警報透過了解每個指標在每個時間點的“正常”情況來解決這兩個問題。
| 方面 | 基於閾值的 | 預測(人工智慧) |
|---|---|---|
| 誤報率 | 40–70% | 3–8% |
| 停電前的準備時間 | 0 分鐘(反應) | 15–45 分鐘(預測) |
| 適應負載模式 | 否,需要手動調整 | 是的,自動基線學習 |
| 多指標相關性 | 手動規則鏈 | 自動交叉度量分析 |
| 季節意識 | 沒有任何 | 每日、每週、每月迴圈 |
| 設定複雜性 | 低的 | 中等(初始訓練期) |
| 維護 | 高(恆定閾值調整) | 低(自適應型號) |
用於自然語言資料庫查詢和最佳化的 LLM 整合
像 GPT-4 和 Claude 這樣的大型語言模型可以充當智慧資料庫助手,將自然語言問題翻譯成 SQL、分析 EXPLAIN 計劃並提出最佳化建議。此功能改變了 DBA 和開發人員與資料庫互動的方式 - 他們可以用簡單的英語描述問題並獲得可行的建議,而不是手動剖析執行計劃。
構建 LLM 查詢最佳化器
以下 Python 實現建立了一個由 LLM 支援的查詢最佳化助手,用於分析 EXPLAIN 計劃並提出改進建議。它與 OpenAI 的 API 整合,幷包括模式感知上下文構建。
# llm_query_optimizer.py — AI-powered database query optimization
import openai
import json
import mysql.connector
import psycopg2
import logging
from dataclasses import dataclass
from typing import Optional

logger = logging.getLogger(__name__)


@dataclass
class QueryAnalysis:
    original_query: str
    explain_plan: dict
    schema_context: str
    suggestions: list
    optimized_query: Optional[str]
    estimated_improvement: str


class LLMQueryOptimizer:
    def __init__(self, api_key, db_config, db_type='mysql', model='gpt-4'):
        self.client = openai.OpenAI(api_key=api_key)
        self.db_config = db_config
        self.db_type = db_type
        self.model = model

    def get_explain_plan(self, query):
        """Execute EXPLAIN ANALYZE and return the plan."""
        if self.db_type == 'mysql':
            conn = mysql.connector.connect(**self.db_config)
            cursor = conn.cursor(dictionary=True)
            cursor.execute(f'EXPLAIN FORMAT=JSON {query}')
            plan = cursor.fetchone()
            cursor.close()
            conn.close()
            return json.loads(plan['EXPLAIN'])
        elif self.db_type == 'postgresql':
            conn = psycopg2.connect(**self.db_config)
            cursor = conn.cursor()
            cursor.execute(f'EXPLAIN (FORMAT JSON, ANALYZE, BUFFERS) {query}')
            plan = cursor.fetchone()[0]
            cursor.close()
            conn.close()
            return plan

    def get_schema_context(self, tables):
        """Extract schema DDL and statistics for context."""
        context_parts = []
        if self.db_type == 'mysql':
            conn = mysql.connector.connect(**self.db_config)
            cursor = conn.cursor()
            for table in tables:
                cursor.execute(f'SHOW CREATE TABLE {table}')
                row = cursor.fetchone()
                context_parts.append(f'-- Table: {table}\n{row[1]}')

                cursor.execute(f'SHOW INDEX FROM {table}')
                indexes = cursor.fetchall()
                idx_info = '\n'.join([f'  Index: {idx[2]}, Column: {idx[4]}, Cardinality: {idx[6]}' for idx in indexes])
                context_parts.append(f'-- Indexes for {table}:\n{idx_info}')

                cursor.execute(f"SELECT table_rows, data_length, index_length FROM information_schema.tables WHERE table_name = '{table}'")
                stats = cursor.fetchone()
                if stats:
                    context_parts.append(f'-- Stats: rows={stats[0]}, data_size={stats[1]}, index_size={stats[2]}')
            cursor.close()
            conn.close()

        return '\n\n'.join(context_parts)

    def analyze_query(self, query, tables):
        """Full LLM analysis of a slow query."""
        explain_plan = self.get_explain_plan(query)
        schema_context = self.get_schema_context(tables)

        prompt = f"""You are an expert database administrator specializing in {self.db_type} performance tuning.

Analyze the following slow query, its EXPLAIN plan, and the schema context. Provide:
1. Root cause of poor performance
2. Specific index recommendations (with CREATE INDEX statements)
3. Query rewrite suggestions (with the rewritten SQL)
4. Estimated performance improvement
5. Any schema changes that would help

## Original Query
```sql
{query}
```

## EXPLAIN Plan
```json
{json.dumps(explain_plan, indent=2)}
```

## Schema Context
```
{schema_context}
```

Respond in JSON format:
{{
  "root_cause": "...",
  "index_recommendations": ["CREATE INDEX ...", ...],
  "rewritten_query": "SELECT ...",
  "estimated_improvement": "Nx faster",
  "schema_changes": ["..."],
  "explanation": "..."
}}"""

        response = self.client.chat.completions.create(
            model=self.model,
            messages=[
                {'role': 'system', 'content': 'You are an expert DBA. Return valid JSON only.'},
                {'role': 'user', 'content': prompt}
            ],
            temperature=0.1,
            response_format={'type': 'json_object'}
        )

        result = json.loads(response.choices[0].message.content)

        return QueryAnalysis(
            original_query=query,
            explain_plan=explain_plan,
            schema_context=schema_context,
            suggestions=result.get('index_recommendations', []),
            optimized_query=result.get('rewritten_query'),
            estimated_improvement=result.get('estimated_improvement', 'Unknown')
        )

    def batch_optimize(self, slow_query_log_path, top_n=20):
        """Parse slow query log and optimize the top N most impactful queries."""
        queries = self._parse_slow_log(slow_query_log_path)
        sorted_queries = sorted(queries, key=lambda q: q['total_time'], reverse=True)[:top_n]

        results = []
        for q in sorted_queries:
            try:
                tables = self._extract_tables(q['query'])
                analysis = self.analyze_query(q['query'], tables)
                results.append({
                    'query': q['query'],
                    'frequency': q['count'],
                    'total_time': q['total_time'],
                    'analysis': analysis
                })
                logger.info(f'Optimized query (est. {analysis.estimated_improvement}): {q["query"][:80]}')
            except Exception as e:
                logger.error(f'Failed to analyze query: {e}')
        return results

    def _parse_slow_log(self, path):
        queries = {}
        current_query = []
        current_time = 0
        with open(path) as f:
            for line in f:
                if line.startswith('# Query_time:'):
                    parts = line.split()
                    current_time = float(parts[2])
                elif line.startswith('SET timestamp') or line.startswith('#'):
                    continue
                elif line.strip().endswith(';'):
                    current_query.append(line.strip())
                    full_query = ' '.join(current_query)
                    if full_query not in queries:
                        queries[full_query] = {'query': full_query, 'count': 0, 'total_time': 0}
                    queries[full_query]['count'] += 1
                    queries[full_query]['total_time'] += current_time
                    current_query = []
                else:
                    current_query.append(line.strip())
        return list(queries.values())

    def _extract_tables(self, query):
        import re
        tables = set()
        for match in re.finditer(r'(?:FROM|JOIN|INTO|UPDATE)\s+[`"]?(\w+)[`"]?', query, re.IGNORECASE):
            tables.add(match.group(1))
        return list(tables)


if __name__ == '__main__':
    import os
    optimizer = LLMQueryOptimizer(
        api_key=os.environ['OPENAI_API_KEY'],
        db_config={'host': 'localhost', 'user': 'root', 'password': '', 'database': 'app_db'},
        db_type='mysql'
    )
    analysis = optimizer.analyze_query(
        'SELECT * FROM orders o JOIN users u ON o.user_id = u.id WHERE o.status = "pending" AND o.created_at > "2026-01-01" ORDER BY o.created_at DESC LIMIT 100',
        ['orders', 'users']
    )
    print(json.dumps(analysis.__dict__, indent=2, default=str))
自動修復工作流程
自動修復是人工智慧驅動的資料庫監控提供最切實的投資回報率的地方。系統不會在凌晨 3 點叫醒 DBA 來終止失控的查詢或擴充套件只讀副本,而是透過完整的審計跟蹤和置信度評分來自動處理它。
# auto_remediation.py — Automated database issue remediation
import subprocess
import mysql.connector
import psycopg2
import pymongo
import redis
import logging
import json
from datetime import datetime
from enum import Enum

logger = logging.getLogger(__name__)


class Severity(Enum):
    LOW = 'low'
    MEDIUM = 'medium'
    HIGH = 'high'
    CRITICAL = 'critical'


class RemediationAction:
    def __init__(self, name, description, severity_threshold, confidence_threshold=0.9):
        self.name = name
        self.description = description
        self.severity_threshold = severity_threshold
        self.confidence_threshold = confidence_threshold


class AutoRemediator:
    def __init__(self, db_configs, notification_webhook=None):
        self.db_configs = db_configs
        self.webhook = notification_webhook
        self.action_log = []

    def _log_action(self, action, target, result, confidence):
        entry = {
            'timestamp': datetime.utcnow().isoformat(),
            'action': action,
            'target': target,
            'result': result,
            'confidence': confidence
        }
        self.action_log.append(entry)
        logger.info(f'Remediation: {json.dumps(entry)}')
        if self.webhook:
            self._notify(entry)

    def kill_long_running_queries(self, db_type='mysql', max_duration_seconds=300, confidence=0.95):
        """Kill queries exceeding duration threshold."""
        if confidence < 0.9:
            logger.warning(f'Low confidence ({confidence}), skipping kill action')
            return []

        killed = []
        if db_type == 'mysql':
            conn = mysql.connector.connect(**self.db_configs['mysql'])
            cursor = conn.cursor(dictionary=True)
            cursor.execute("""
                SELECT id, user, host, db, time, state, info
                FROM information_schema.processlist
                WHERE command != 'Sleep'
                  AND time > %s
                  AND user != 'system user'
                ORDER BY time DESC
            """, (max_duration_seconds,))

            for proc in cursor.fetchall():
                try:
                    cursor.execute(f'KILL {proc["id"]}')
                    killed.append(proc)
                    self._log_action('kill_query', f'mysql:{proc["id"]}', 'success', confidence)
                except Exception as e:
                    self._log_action('kill_query', f'mysql:{proc["id"]}', f'failed: {e}', confidence)

            cursor.close()
            conn.close()

        elif db_type == 'postgresql':
            conn = psycopg2.connect(**self.db_configs['postgresql'])
            cursor = conn.cursor()
            cursor.execute("""
                SELECT pid, usename, application_name, state,
                       extract(epoch from now() - query_start) as duration, query
                FROM pg_stat_activity
                WHERE state = 'active'
                  AND extract(epoch from now() - query_start) > %s
                  AND usename != 'postgres'
            """, (max_duration_seconds,))

            for row in cursor.fetchall():
                try:
                    cursor.execute('SELECT pg_terminate_backend(%s)', (row[0],))
                    conn.commit()
                    killed.append({'pid': row[0], 'user': row[1], 'duration': row[4]})
                    self._log_action('kill_query', f'pg:{row[0]}', 'success', confidence)
                except Exception as e:
                    self._log_action('kill_query', f'pg:{row[0]}', f'failed: {e}', confidence)

            cursor.close()
            conn.close()

        return killed

    def scale_read_replicas(self, platform='kubernetes', target_replicas=None, confidence=0.92):
        """Scale database read replicas based on load prediction."""
        if confidence < 0.85:
            logger.warning('Insufficient confidence for scaling action')
            return None

        if platform == 'kubernetes':
            cmd = f'kubectl scale statefulset mysql-read --replicas={target_replicas}'
            result = subprocess.run(cmd.split(), capture_output=True, text=True)
            self._log_action('scale_replicas', f'k8s:mysql-read:{target_replicas}', result.stdout.strip(), confidence)
            return result.stdout
        elif platform == 'aws':
            import boto3
            rds = boto3.client('rds')
            response = rds.create_db_instance_read_replica(
                DBInstanceIdentifier=f'read-replica-{datetime.now().strftime("%Y%m%d%H%M")}',
                SourceDBInstanceIdentifier='production-primary'
            )
            self._log_action('create_replica', 'aws:rds', response['DBInstance']['DBInstanceIdentifier'], confidence)
            return response

    def trigger_failover(self, db_type='mysql', confidence=0.98):
        """Initiate database failover when primary is unhealthy."""
        if confidence < 0.95:
            logger.critical(f'Failover requires confidence >= 0.95, got {confidence}. Escalating to human.')
            self._notify({'action': 'failover_escalation', 'confidence': confidence})
            return None

        self._log_action('failover_initiated', db_type, 'starting', confidence)

        if db_type == 'mysql':
            result = subprocess.run(
                ['mysqlsh', '--', 'dba', 'switchToSecondary'],
                capture_output=True, text=True
            )
            self._log_action('failover', 'mysql:innodb_cluster', result.stdout.strip(), confidence)
        elif db_type == 'postgresql':
            result = subprocess.run(
                ['patronictl', 'failover', '--force'],
                capture_output=True, text=True
            )
            self._log_action('failover', 'pg:patroni', result.stdout.strip(), confidence)

    def flush_redis_hotspot(self, pattern, confidence=0.9):
        """Identify and handle Redis key hotspots."""
        r = redis.Redis(**self.db_configs['redis'])
        cursor = 0
        hot_keys = []
        while True:
            cursor, keys = r.scan(cursor, match=pattern, count=1000)
            for key in keys:
                idle = r.object('idletime', key)
                if idle is not None and idle < 5:
                    hot_keys.append(key.decode())
            if cursor == 0:
                break

        if hot_keys:
            self._log_action('hotspot_detected', f'redis:{pattern}', f'{len(hot_keys)} hot keys', confidence)
        return hot_keys

    def run_pg_vacuum(self, table, confidence=0.92):
        """Force VACUUM ANALYZE on bloated PostgreSQL tables."""
        conn = psycopg2.connect(**self.db_configs['postgresql'])
        conn.autocommit = True
        cursor = conn.cursor()
        cursor.execute(f'VACUUM (VERBOSE, ANALYZE) {table}')
        self._log_action('vacuum', f'pg:{table}', 'completed', confidence)
        cursor.close()
        conn.close()

    def _notify(self, payload):
        import requests
        try:
            requests.post(self.webhook, json=payload, timeout=5)
        except Exception as e:
            logger.error(f'Notification failed: {e}')
MySQL 特定的 AI 故障排除
MySQL 提出了獨特的挑戰,這些挑戰可以從人工智慧分析中受益匪淺。 InnoDB 緩衝池管理、死鎖檢測、慢速查詢模式識別和複製延遲預測都需要根據 MySQL 特定指標進行訓練的專門 ML 模型。
使用 ML 進行慢速查詢分析
ML 模型不是手動檢查慢速查詢日誌,而是根據查詢的效能影響和根本原因對查詢進行分類。常見模式包括缺失索引、笛卡爾連線、索引列上具有函式的次優 WHERE 子句以及寬表上的 SELECT *。
InnoDB緩衝池最佳化
緩衝池命中率是 MySQL 最關鍵的指標。 AI 模型學習工作負載模式和緩衝池有效性之間的關係,預測命中率何時會下降並建議主動調整 innodb_buffer_pool_size。根據緩衝池指標訓練的 LSTM 模型可以在影響查詢延遲之前 30 分鐘預測快取壓力。
死鎖檢測和預防
AI 分析 InnoDB 死鎖圖以識別重複出現的模式。系統不僅僅在死鎖發生後記錄死鎖,還可以瞭解哪些事務序列導致死鎖,並可以預先重新排序操作或調整隔離級別。
PostgreSQL-特定 AI 故障排除
PostgreSQL 的 MVCC 架構圍繞表膨脹、真空排程和 WAL 管理帶來了獨特的挑戰,這些挑戰受益於人工智慧驅動的分析。
真空分析和膨脹檢測
人工智慧模型跟蹤交易率、死元組積累和自動清理有效性之間的關係。透過了解每個表的膨脹增長率,系統可以預測表何時達到有問題的膨脹水平,並在效能下降之前觸發有針對性的清理操作。
指數推薦
一起分析 pg_stat_user_indexes 和 pg_stat_statements 可以揭示索引使用模式。 AI 可以識別消耗磁碟空間的未使用索引,並根據查詢模式建議新索引 - 考慮附加索引的寫入放大成本與讀取效能優勢。
連線池最佳化
PostgreSQL 處理連線的方式與 MySQL 不同,每個連線消耗的記憶體明顯更多。 AI 模型分析 PgBouncer 上的連線池利用率模式,以確定不同工作負載配置檔案(OLTP、OLAP、混合)的最佳池大小,從而防止連線匱乏和記憶體耗盡。
MongoDB 特定的 AI 故障排除
MongoDB 的文件模型和分散式架構帶來了一系列獨特的效能挑戰,而 AI 可以有效地解決這些挑戰。
指數建議
MongoDB 查詢分析器的 AI 分析可識別執行集合掃描 (COLLSCAN) 的查詢,並根據查詢欄位組合推薦複合索引。該模型考慮選擇性、欄位順序和覆蓋查詢最佳化來生成最佳索引規範。
分片最佳化
對於分片叢集,AI 會監控塊分佈、遷移率和查詢路由模式。當它檢測到分片利用率不均勻(熱分片)時,它會建議分片鍵更改或預分割策略。機器學習模型預測塊增長率,以便在效能影響發生之前主動平衡資料分佈。
WiredTiger快取分析
WiredTiger 快取逐出模式揭示了工作負載特徵。 AI 模型可以瞭解工作集增長與低效訪問模式何時導致快取壓力,從而建議增加快取大小或進行應用程式級更改(例如查詢批處理)。
Redis 特定的 AI 故障排除
Redis 的執行限制與基於磁碟的資料庫不同——記憶體是關鍵資源,延遲要求通常為亞毫秒級。
記憶體分析
AI 跟蹤記憶體碎片率、金鑰大小分佈和 TTL 模式。當碎片超過健康閾值時,系統會確定 ACTIVEDEFRAG 調整或受控重啟是否是更好的補救措施。 ML 模型預測記憶體增長軌跡以防止 OOM 終止。
關鍵模式檢測和熱點識別
使用 MONITOR 取樣和 OBJECT FREQ 分析,AI 可以識別導致叢集插槽之間負載分佈不均勻的熱鍵。對於Redis叢集部署,系統會檢測槽遷移瓶頸並建議更改關鍵命名以改善雜湊槽分佈。
驅逐政策最佳化
不同的工作負載受益於不同的逐出策略(易失性-lru、allkeys-lfu、易失性-ttl)。人工智慧分析訪問模式以推薦最佳的最大記憶體策略,並根據當前的金鑰訪問分佈預測每個策略的命中率影響。
Couchbase 特定的 AI 故障排除
Couchbase 結合了文件儲存、鍵值和類似 SQL (N1QL) 的查詢功能,建立了獨特的最佳化環境。
N1QL 查詢最佳化
AI 分析 N1QL 查詢模式和 EXPLAIN 輸出,以建議 GSI(全域性二級索引)建立、涵蓋的索引策略和查詢重寫。系統會了解哪些 N1QL 模式始終會產生次優計劃,並主動建議替代方案。
指數顧問整合
Couchbase 的內建索引顧問提供了建議,但 AI 透過考慮全域性工作負載來增強這些建議,即在整個應用程式的訪問模式中平衡索引建立成本和查詢收益,而不是孤立地進行單個查詢。
再平衡規劃
當新增或刪除節點時,Couchbase 必須重新平衡資料。 AI 根據歷史叢集行為預測重新平衡持續時間、資源影響和最佳時間視窗。這可以防止重新平衡操作在高峰時段影響生產流量。
多資料庫AI可觀測架構
大多數生產環境執行多個資料庫引擎。統一的人工智慧可觀測性平臺必須標準化跨引擎的指標,關聯整個資料層的異常,並向運營團隊提供一致的檢視。
使用 ChatGPT 和 Claude 構建自定義 AI 資料庫助手
將 LLM 與您的資料庫基礎架構整合,建立一個互動式 DBA 助手,可以回答自然語言問題、診斷問題並執行修復工作流程。該助手將檢索增強生成 (RAG) 與實時指標訪問相結合。
# ai_dba_assistant.py — Custom AI DBA assistant with tool integration
import openai
import json
import os
from datetime import datetime


class AIDBAssistant:
    def __init__(self, db_connections, prometheus_url):
        self.client = openai.OpenAI(api_key=os.environ['OPENAI_API_KEY'])
        self.db_conns = db_connections
        self.prom_url = prometheus_url
        self.conversation_history = []
        self.tools = [
            {
                'type': 'function',
                'function': {
                    'name': 'query_prometheus',
                    'description': 'Execute a PromQL query to fetch database metrics',
                    'parameters': {
                        'type': 'object',
                        'properties': {
                            'query': {'type': 'string', 'description': 'PromQL query'},
                            'duration': {'type': 'string', 'description': 'Time range (e.g. 1h, 24h)'}
                        },
                        'required': ['query']
                    }
                }
            },
            {
                'type': 'function',
                'function': {
                    'name': 'run_explain',
                    'description': 'Run EXPLAIN on a SQL query',
                    'parameters': {
                        'type': 'object',
                        'properties': {
                            'query': {'type': 'string'},
                            'db_type': {'type': 'string', 'enum': ['mysql', 'postgresql']}
                        },
                        'required': ['query', 'db_type']
                    }
                }
            },
            {
                'type': 'function',
                'function': {
                    'name': 'get_active_queries',
                    'description': 'List currently running database queries',
                    'parameters': {
                        'type': 'object',
                        'properties': {
                            'db_type': {'type': 'string', 'enum': ['mysql', 'postgresql', 'mongodb']},
                            'min_duration_seconds': {'type': 'integer', 'default': 0}
                        },
                        'required': ['db_type']
                    }
                }
            },
            {
                'type': 'function',
                'function': {
                    'name': 'kill_query',
                    'description': 'Terminate a running database query by ID',
                    'parameters': {
                        'type': 'object',
                        'properties': {
                            'db_type': {'type': 'string'},
                            'process_id': {'type': 'integer'}
                        },
                        'required': ['db_type', 'process_id']
                    }
                }
            }
        ]

    def chat(self, user_message):
        self.conversation_history.append({'role': 'user', 'content': user_message})

        system_prompt = """You are an expert DBA assistant with access to real-time database monitoring tools.
You can query Prometheus metrics, analyze EXPLAIN plans, view active queries, and kill problematic queries.
Always ground your answers in actual data by using the available tools.
When diagnosing issues, follow this methodology:
1. Check current metrics for anomalies
2. Identify root cause
3. Suggest specific remediation steps
4. Execute remediation if the user approves"""

        messages = [{'role': 'system', 'content': system_prompt}] + self.conversation_history

        response = self.client.chat.completions.create(
            model='gpt-4',
            messages=messages,
            tools=self.tools,
            tool_choice='auto'
        )

        message = response.choices[0].message

        if message.tool_calls:
            for tool_call in message.tool_calls:
                fn_name = tool_call.function.name
                fn_args = json.loads(tool_call.function.arguments)
                result = self._execute_tool(fn_name, fn_args)
                self.conversation_history.append(message)
                self.conversation_history.append({
                    'role': 'tool',
                    'tool_call_id': tool_call.id,
                    'content': json.dumps(result)
                })

            follow_up = self.client.chat.completions.create(
                model='gpt-4',
                messages=[{'role': 'system', 'content': system_prompt}] + self.conversation_history
            )
            assistant_reply = follow_up.choices[0].message.content
        else:
            assistant_reply = message.content

        self.conversation_history.append({'role': 'assistant', 'content': assistant_reply})
        return assistant_reply

    def _execute_tool(self, name, args):
        if name == 'query_prometheus':
            from prometheus_api_client import PrometheusConnect
            prom = PrometheusConnect(url=self.prom_url)
            return prom.custom_query(args['query'])
        elif name == 'run_explain':
            return {'plan': 'EXPLAIN output here'}
        elif name == 'get_active_queries':
            return {'queries': []}
        elif name == 'kill_query':
            return {'status': 'killed', 'process_id': args['process_id']}
        return {'error': f'Unknown tool: {name}'}
Prometheus + Grafana + ML 管道設定
可觀測性堆疊構成了人工智慧資料庫監控的支柱。 Prometheus 從資料庫匯出器中抓取指標,Grafana 將其視覺化,ML 管道處理時間序列資料以進行異常檢測。
多資料庫監控的 Prometheus 配置
# prometheus.yml — Multi-database monitoring configuration
global:
  scrape_interval: 15s
  evaluation_interval: 15s

rule_files:
  - /etc/prometheus/rules/db_anomaly_rules.yml

alerting:
  alertmanagers:
    - static_configs:
        - targets: ['alertmanager:9093']

scrape_configs:
  - job_name: 'mysql'
    static_configs:
      - targets: ['mysql-exporter:9104']
    metrics_path: /metrics
    scrape_interval: 10s

  - job_name: 'postgresql'
    static_configs:
      - targets: ['postgres-exporter:9187']
    scrape_interval: 10s

  - job_name: 'mongodb'
    static_configs:
      - targets: ['mongodb-exporter:9216']
    scrape_interval: 15s

  - job_name: 'redis'
    static_configs:
      - targets: ['redis-exporter:9121']
    scrape_interval: 10s

  - job_name: 'couchbase'
    static_configs:
      - targets: ['couchbase-exporter:9420']
    scrape_interval: 15s

remote_write:
  - url: http://victoriametrics:8428/api/v1/write
自定義 Grafana 儀表板配置
# grafana_dashboard_generator.py — Auto-generate AI-powered Grafana dashboards
import json
import requests


class GrafanaDashboardGenerator:
    def __init__(self, grafana_url, api_key):
        self.url = grafana_url
        self.headers = {'Authorization': f'Bearer {api_key}', 'Content-Type': 'application/json'}

    def create_db_overview_dashboard(self):
        dashboard = {
            'dashboard': {
                'title': 'AI Database Health Overview',
                'tags': ['database', 'ai', 'monitoring'],
                'timezone': 'browser',
                'panels': [
                    self._anomaly_score_panel(grid_pos={'x': 0, 'y': 0, 'w': 12, 'h': 8}),
                    self._query_latency_panel(grid_pos={'x': 12, 'y': 0, 'w': 12, 'h': 8}),
                    self._connection_pool_panel(grid_pos={'x': 0, 'y': 8, 'w': 8, 'h': 8}),
                    self._replication_lag_panel(grid_pos={'x': 8, 'y': 8, 'w': 8, 'h': 8}),
                    self._buffer_cache_panel(grid_pos={'x': 16, 'y': 8, 'w': 8, 'h': 8}),
                    self._remediation_log_panel(grid_pos={'x': 0, 'y': 16, 'w': 24, 'h': 6})
                ],
                'refresh': '10s'
            },
            'overwrite': True
        }
        resp = requests.post(f'{self.url}/api/dashboards/db', headers=self.headers, json=dashboard)
        return resp.json()

    def _anomaly_score_panel(self, grid_pos):
        return {
            'title': 'AI Anomaly Score (All Databases)',
            'type': 'timeseries',
            'gridPos': grid_pos,
            'targets': [
                {'expr': 'db_anomaly_score{db_type="mysql"}', 'legendFormat': 'MySQL'},
                {'expr': 'db_anomaly_score{db_type="postgresql"}', 'legendFormat': 'PostgreSQL'},
                {'expr': 'db_anomaly_score{db_type="mongodb"}', 'legendFormat': 'MongoDB'},
                {'expr': 'db_anomaly_score{db_type="redis"}', 'legendFormat': 'Redis'},
                {'expr': 'db_anomaly_score{db_type="couchbase"}', 'legendFormat': 'Couchbase'}
            ],
            'fieldConfig': {
                'defaults': {
                    'thresholds': {
                        'steps': [
                            {'value': 0, 'color': 'green'},
                            {'value': 0.5, 'color': 'yellow'},
                            {'value': 0.8, 'color': 'red'}
                        ]
                    },
                    'max': 1, 'min': 0
                }
            }
        }

    def _query_latency_panel(self, grid_pos):
        return {
            'title': 'Query Latency P95 with AI Prediction',
            'type': 'timeseries',
            'gridPos': grid_pos,
            'targets': [
                {'expr': 'histogram_quantile(0.95, rate(db_query_duration_seconds_bucket[5m]))', 'legendFormat': 'Actual P95'},
                {'expr': 'db_query_latency_predicted_p95', 'legendFormat': 'AI Predicted P95'}
            ]
        }

    def _connection_pool_panel(self, grid_pos):
        return {
            'title': 'Connection Pool Utilization',
            'type': 'gauge',
            'gridPos': grid_pos,
            'targets': [
                {'expr': 'db_connections_active / db_connections_max * 100', 'legendFormat': '{{db_type}}'}
            ]
        }

    def _replication_lag_panel(self, grid_pos):
        return {
            'title': 'Replication Lag (seconds)',
            'type': 'timeseries',
            'gridPos': grid_pos,
            'targets': [
                {'expr': 'mysql_slave_status_seconds_behind_master', 'legendFormat': 'MySQL'},
                {'expr': 'pg_replication_lag_seconds', 'legendFormat': 'PostgreSQL'},
                {'expr': 'mongodb_replset_member_replication_lag', 'legendFormat': 'MongoDB'}
            ]
        }

    def _buffer_cache_panel(self, grid_pos):
        return {
            'title': 'Buffer/Cache Hit Ratio',
            'type': 'stat',
            'gridPos': grid_pos,
            'targets': [
                {'expr': 'mysql_global_status_innodb_buffer_pool_hit_ratio', 'legendFormat': 'MySQL InnoDB'},
                {'expr': 'pg_stat_database_blks_hit / (pg_stat_database_blks_hit + pg_stat_database_blks_read)', 'legendFormat': 'PostgreSQL'},
                {'expr': 'redis_keyspace_hit_ratio', 'legendFormat': 'Redis'}
            ]
        }

    def _remediation_log_panel(self, grid_pos):
        return {
            'title': 'Auto-Remediation Action Log',
            'type': 'table',
            'gridPos': grid_pos,
            'targets': [
                {'expr': 'db_remediation_actions_total', 'format': 'table', 'instant': True}
            ]
        }
PagerDuty 和 OpsGenie 整合用於智慧警報
智慧警報不僅僅是簡單的 Webhook 通知。人工智慧豐富的警報包括根本原因分析、歷史背景、建議的操作手冊和置信度評分,為待命工程師提供更快解決問題或確認自動修復已處理問題所需的背景資訊。
# intelligent_alerting.py — AI-enriched alerting for PagerDuty and OpsGenie
import requests
import json
from datetime import datetime


class IntelligentAlertManager:
    def __init__(self, pagerduty_key=None, opsgenie_key=None):
        self.pd_key = pagerduty_key
        self.og_key = opsgenie_key

    def send_enriched_alert(self, anomaly, ai_analysis):
        severity = anomaly.get('severity', 'warning')
        pd_severity = {'critical': 'critical', 'warning': 'warning', 'info': 'info'}.get(severity, 'warning')

        details = {
            'anomaly_score': anomaly.get('score', 0),
            'metric': anomaly.get('metric', 'unknown'),
            'root_cause': ai_analysis.get('root_cause', 'Under investigation'),
            'suggested_actions': ai_analysis.get('actions', []),
            'auto_remediation_status': ai_analysis.get('remediation_status', 'pending'),
            'similar_incidents': ai_analysis.get('similar_past_incidents', []),
            'estimated_impact': ai_analysis.get('impact', 'Unknown'),
            'confidence': ai_analysis.get('confidence', 0)
        }

        if self.pd_key:
            self._send_pagerduty(pd_severity, anomaly, details)
        if self.og_key:
            self._send_opsgenie(severity, anomaly, details)

    def _send_pagerduty(self, severity, anomaly, details):
        payload = {
            'routing_key': self.pd_key,
            'event_action': 'trigger',
            'payload': {
                'summary': f'[AI] Database anomaly: {anomaly["metric"]} (score: {anomaly["score"]})',
                'severity': severity,
                'source': 'ai-db-monitor',
                'component': anomaly.get('db_type', 'database'),
                'custom_details': details
            }
        }
        requests.post('https://events.pagerduty.com/v2/enqueue', json=payload)

    def _send_opsgenie(self, severity, anomaly, details):
        payload = {
            'message': f'[AI] Database anomaly: {anomaly["metric"]} (score: {anomaly["score"]})',
            'priority': {'critical': 'P1', 'warning': 'P3', 'info': 'P5'}.get(severity, 'P3'),
            'details': details,
            'tags': ['ai-monitoring', anomaly.get('db_type', 'database')]
        }
        requests.post(
            'https://api.opsgenie.com/v2/alerts',
            headers={'Authorization': f'GenieKey {self.og_key}'},
            json=payload
        )
利用人工智慧進行根本原因分析
當檢測到異常時,確定根本原因是事件響應中最耗時的步驟。人工智慧驅動的根本原因分析將多個訊號(指標異常、日誌模式、跟蹤資料和最近的變化)關聯起來,以便在幾秒鐘而不是幾小時內查明可能的原因。
該方法的工作原理是維護系統依賴性和已知故障模式的知識圖。當異常發生時,人工智慧會遍歷圖表以識別上游原因。例如,如果 MySQL 上的查詢延遲出現峰值,系統會檢查:最近是否有部署?連線數有變化嗎?是否存在複製滯後?磁碟IOPS是否飽和?是否存在鎖爭用?每個訊號都會對不同根本原因的機率得分做出貢獻。
透過 ML 預測進行容量規劃
機器學習驅動的容量規劃超越了反應性擴充套件,轉向了預測性資源管理。透過分析歷史增長模式、季節性週期和計劃的業務事件,機器學習模型可以預測資料庫何時會達到資源限制。
Prophet 擅長容量預測,因為它可以原生處理缺失資料、趨勢變化和季節性模式。使用 90 天的每日儲存增長資料對其進行訓練,並生成帶有置信區間的預測,顯示您何時需要配置額外的儲存。 LSTM 模型更適合短期容量預測——預測未來 24 小時的連線池利用率,以便在早晨流量高峰之前進行預擴充套件。
特定於雲的 AI 工具
適用於 RDS 的 AWS 開發運營大師
AWS DevOps Guru 為 RDS 例項提供基於 ML 的異常檢測。它自動監控 CloudWatch 指標並識別效能異常,並將其與最近的部署或配置更改相關聯。整合需要在 RDS 資源上啟用 DevOps Guru 並配置 SNS 通知。
適用於 Azure SQL 和 Cosmos DB 的 Azure AI
Azure 為 Azure SQL 資料庫提供智慧見解,該資料庫使用內建的 ML 模型來檢測效能迴歸、阻塞查詢和資源限制。 Azure Cosmos DB 包含一個整合的 AI 顧問,用於請求單元最佳化和分割槽鍵選擇。
Cloud SQL 和 Firestore 的 GCP 雲操作
Google Cloud Operations(以前稱為 Stackdriver)為 Cloud SQL 提供智慧警報。該系統會學習指標基線,並僅在行為顯著偏離學習模式時才生成警報,與靜態閾值相比,大大減少了誤報。
開源資料質量工具
阿帕奇·格里芬
Apache Griffin 為大規模資料資產提供資料質量測量。當與人工智慧監控管道整合時,它可以檢測資料質量異常(缺失值、模式漂移、分佈變化),這些異常通常先於資料庫效能問題出現。
遠大的期望
Great Expectations 支援宣告性資料驗證。透過定義對資料庫表的期望(範圍內的行數、界限內的列值、引用完整性),您可以建立一個資料質量監控層,AI 模型可以將其用作異常檢測的附加訊號。
# data_quality_check.py — Great Expectations integration for DB quality monitoring
import great_expectations as gx


def run_database_quality_checks(connection_string, suite_name='db_health'):
    context = gx.get_context()

    datasource = context.data_sources.add_sql(
        name='production_db',
        connection_string=connection_string
    )

    orders_asset = datasource.add_table_asset(name='orders', table_name='orders')
    batch = orders_asset.add_batch_definition_whole_table('full_table').get_batch()

    suite = context.suites.add(
        gx.ExpectationSuite(name=suite_name)
    )

    suite.add_expectation(
        gx.expectations.ExpectTableRowCountToBeBetween(min_value=1000, max_value=10000000)
    )
    suite.add_expectation(
        gx.expectations.ExpectColumnValuesToNotBeNull(column='user_id')
    )
    suite.add_expectation(
        gx.expectations.ExpectColumnValuesToBeUnique(column='order_number')
    )

    validation_result = batch.validate(suite)

    if not validation_result.success:
        failed = [r for r in validation_result.results if not r.success]
        return {
            'status': 'failed',
            'failed_checks': len(failed),
            'details': [{
                'expectation': str(r.expectation_config),
                'observed': r.result
            } for r in failed]
        }
    return {'status': 'passed', 'checks_run': len(validation_result.results)}
完整的管道整合示例
以下編排器將所有元件組合在一起,將指標收集、異常檢測、LLM 分析、警報和自動修復連線到一個連續管道中,該管道可監視生產環境中的所有資料庫引擎。
# pipeline_orchestrator.py — Full AI database monitoring pipeline
import schedule
import time
import logging
from anomaly_detector import DatabaseAnomalyDetector
from auto_remediation import AutoRemediator
from intelligent_alerting import IntelligentAlertManager
from llm_query_optimizer import LLMQueryOptimizer
import json
import os

logging.basicConfig(level=logging.INFO)
logger = logging.getLogger(__name__)


class AIDatabasePipeline:
    def __init__(self):
        self.detector = DatabaseAnomalyDetector(
            prometheus_url=os.environ['PROMETHEUS_URL']
        )
        self.remediator = AutoRemediator(
            db_configs={
                'mysql': {'host': os.environ['MYSQL_HOST'], 'user': 'monitor', 'password': os.environ['MYSQL_PASS'], 'database': 'production'},
                'postgresql': {'host': os.environ['PG_HOST'], 'user': 'monitor', 'password': os.environ['PG_PASS'], 'dbname': 'production'},
                'redis': {'host': os.environ['REDIS_HOST'], 'port': 6379}
            },
            notification_webhook=os.environ.get('SLACK_WEBHOOK')
        )
        self.alerter = IntelligentAlertManager(
            pagerduty_key=os.environ.get('PAGERDUTY_KEY'),
            opsgenie_key=os.environ.get('OPSGENIE_KEY')
        )
        self.optimizer = LLMQueryOptimizer(
            api_key=os.environ['OPENAI_API_KEY'],
            db_config={'host': os.environ['MYSQL_HOST'], 'user': 'root', 'password': os.environ['MYSQL_PASS'], 'database': 'production'},
            db_type='mysql'
        )

    def run_anomaly_detection_cycle(self):
        """Main detection cycle — runs every minute."""
        for db_type in ['mysql', 'postgresql']:
            try:
                results = self.detector.run_full_analysis(db_type)
                logger.info(f'{db_type}: {results["summary"]["total_anomalies"]} anomalies found')

                for anomaly in results['anomalies']:
                    if anomaly['severity'] == 'critical':
                        ai_analysis = self._analyze_anomaly(anomaly, db_type)
                        self.alerter.send_enriched_alert(anomaly, ai_analysis)

                        if ai_analysis.get('confidence', 0) > 0.95:
                            self._auto_remediate(anomaly, db_type, ai_analysis)
            except Exception as e:
                logger.error(f'Detection cycle failed for {db_type}: {e}')

    def run_query_optimization_cycle(self):
        """Batch query optimization — runs daily."""
        try:
            results = self.optimizer.batch_optimize('/var/log/mysql/slow.log', top_n=10)
            for r in results:
                logger.info(f'Query optimized: {r["analysis"].estimated_improvement}')
        except Exception as e:
            logger.error(f'Query optimization failed: {e}')

    def _analyze_anomaly(self, anomaly, db_type):
        return {
            'root_cause': f'Anomaly in {anomaly["metric"]} for {db_type}',
            'confidence': anomaly.get('score', 0.5),
            'actions': ['investigate', 'scale_if_needed'],
            'remediation_status': 'pending'
        }

    def _auto_remediate(self, anomaly, db_type, analysis):
        metric = anomaly.get('metric', '')
        confidence = analysis.get('confidence', 0)

        if 'slow_queries' in metric or 'query_latency' in metric:
            self.remediator.kill_long_running_queries(db_type=db_type, confidence=confidence)
        elif 'connections' in metric:
            self.remediator.scale_read_replicas(target_replicas=5, confidence=confidence)
        elif 'repl_lag' in metric and confidence > 0.98:
            self.remediator.trigger_failover(db_type=db_type, confidence=confidence)

        logger.info(f'Auto-remediation executed for {metric} on {db_type}')

    def start(self):
        logger.info('AI Database Pipeline started')
        schedule.every(1).minutes.do(self.run_anomaly_detection_cycle)
        schedule.every(1).day.at('02:00').do(self.run_query_optimization_cycle)

        while True:
            schedule.run_pending()
            time.sleep(10)


if __name__ == '__main__':
    pipeline = AIDatabasePipeline()
    pipeline.start()
跟蹤 AI 資料庫監控成功的關鍵指標
| 公制 | 人工智慧出現之前 | 人工智慧之後 | 改進 |
|---|---|---|---|
| 平均檢測時間 (MTTD) | 15–30 分鐘 | 30 秒–2 分鐘 | 90–95% |
| 平均解決時間 (MTTR) | 45–120 分鐘 | 2–5 分鐘 | 95%+ |
| 誤報率 | 50–70% | 3–8% | 90%+ |
| 自動解決事件 | 0% | 35–50% | 不適用 |
| DBA 每週待命頁面 | 40–60 | 5–10 | 80%+ |
| 查詢最佳化時間 | 每次查詢 2-4 小時 | 每個查詢 5 分鐘 | 95%+ |
| 容量規劃準確性 | 60%(手動估算) | 90%+(機器學習預測) | 50%+ |
最佳實踐和生產注意事項
- 從可觀察性開始,然後新增智慧。 在部署機器學習模型之前確保全面的指標收集到位。您無法檢測未收集的資料中的異常情況。
- 使用置信閾值進行修復。 為故障轉移等破壞性操作設定高置信度欄(95% 或以上),為擴充套件等非破壞性操作設定較低閾值(85%)。
- 保持人為監督。 自動修復應始終記錄操作並通知人類。諸如故障轉移之類的關鍵操作應該需要更高的信心或明確的人工批准。
- 定期重新訓練模型。 資料庫工作負載模式隨著應用程式的變化而發展。至少每週重新訓練異常檢測模型,或實施持續適應的線上學習。
- 首先在分期中測試修復。 在投入生產之前,每個自動修復工作流程都應在具有混沌工程場景的臨時環境中進行驗證。
- 結合多種機器學習方法。 沒有一種演算法可以處理所有異常型別。使用結合 Prophet(季節性)、LSTM(順序)和隔離森林(多元)的整合方法來實現全面覆蓋。
- 安全的 LLM 整合。 使用 LLM 進行查詢分析時,切勿傳送實際資料值 - 僅傳送模式後設資料和 EXPLAIN 計劃。對 AI 工具使用專用的只讀資料庫憑據。
- 建立反饋迴圈。 跟蹤異常檢測的誤報率和漏報率。使用有關警報相關性的人工反饋來不斷提高模型的準確性。
結論
人工智慧驅動的資料庫故障排除代表了從被動消防到主動智慧操作的根本轉變。透過結合時間序列異常檢測、LLM 支援的查詢最佳化、預測性警報和自動修復,團隊可以實現亞分鐘級檢測、大幅減少錯誤警報並顯著縮短平均解決時間。關鍵是逐步構建——從指標收集和儀表板開始,分層異常檢測,然後隨著對系統信心的增長逐步啟用自動修復。無論您是管理 MySQL、PostgreSQL、MongoDB、Redis 還是 Couchbase,AI 驅動的方法都適用,適應每個引擎的獨特特徵,同時在整個資料層提供統一的可觀察性體驗。